Apple y Meta ponen un modelo de 816B en cuatro Mac Studio
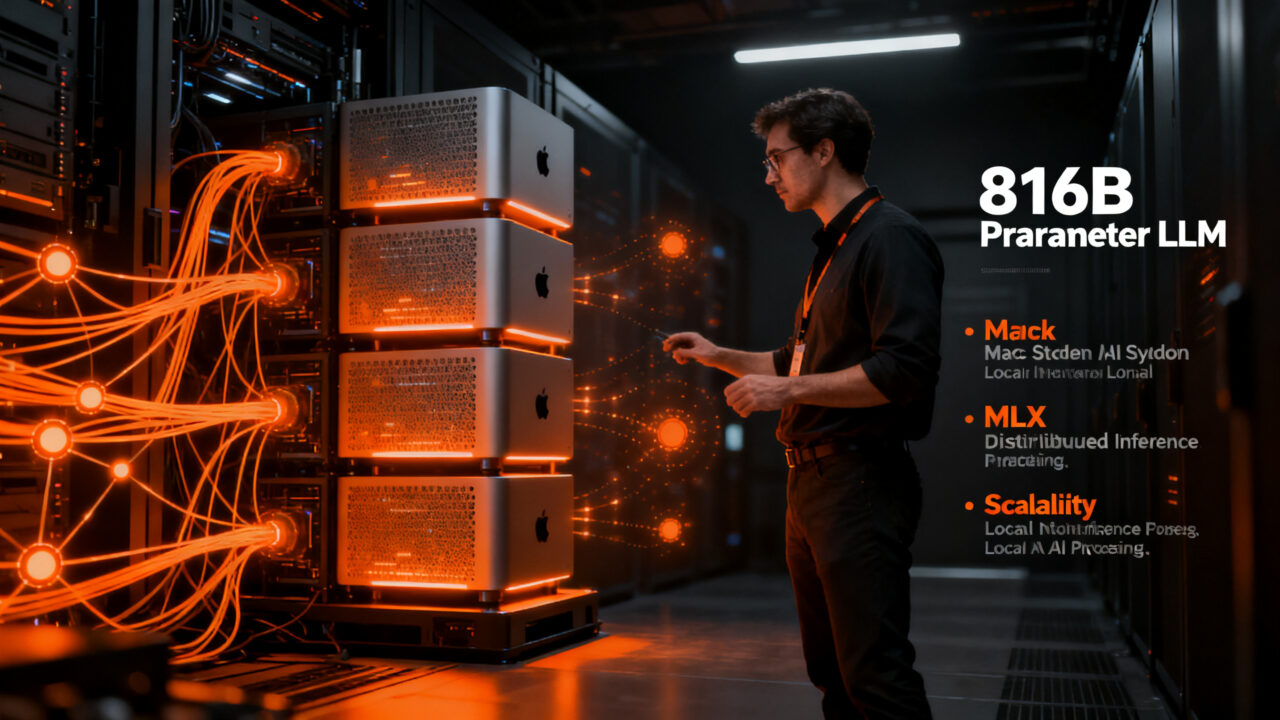
Muse Spark Open, el modelo abierto de Meta con 816.000 millones de parámetros (816B), corre en un clúster de cuatro Mac Studio con chip M5 Ultra a 36,73 tokens por segundo: por encima de la velocidad de lectura humana. La pieza que lo hace posible es MLX, el framework de código abierto de Apple, que ahora reparte la inferencia entre varias máquinas conectadas por Thunderbolt 5.
El dato que importa para un founder no es el benchmark en sí: es que un modelo de frontera que hasta hace poco obligaba a rentar GPUs en la nube hoy cabe en cuatro equipos de escritorio que se enchufan en cualquier oficina. Apple publicó los detalles técnicos junto con la última versión de MLX.
¿Qué es Muse Spark Open y por qué Meta se alió con Apple?
Meta presentó el modelo el 15 de octubre, según MacRumors, y lo posicionó como el modelo abierto más capaz lanzado hasta ahora en Estados Unidos. Es una arquitectura de mezcla de expertos (MoE): de sus 816B parámetros totales, solo 42B se activan por token, lo que reduce el cómputo en cada paso de inferencia sin recortar la capacidad del modelo.
Leíste lo que hace la IA. ¿Y en tu negocio?
En CAR, dueños de empresa arman en 7 días su primer sistema funcionando: que ningún cliente se les escape, o que el informe del lunes salga solo. Con otros emprendedores al lado.
👥 Probar 7 díasEstá pensado para código, agentes y razonamiento multi-paso, con una ventana de contexto de hasta un millón de tokens. Los pesos se pueden descargar gratis desde Hugging Face, Amazon SageMaker AI, Google Cloud Model Garden y Microsoft Foundry Models, y el modelo también está disponible vía API en Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter y Together AI.
Lo curioso es la alianza. Apple y Meta suelen chocar en privacidad y publicidad, y el jefe de IA de Meta, Alexandr Wang, lo resumió a Axios con una frase entre irónica y celebratoria: "We're excited for mommy and daddy to be playing nice again." La colaboración existió porque Meta necesitaba el hardware y Apple necesitaba modelos que justifiquen su hardware.
¿Qué cambia el M5 Ultra frente al M3 Ultra en inferencia local?
Apple comparó las dos generaciones de Mac Studio con dos métricas que miden cosas distintas. El time to first token (TTFT) es una carga de cómputo puro: ahí las Neural Accelerators del GPU del M5 Ultra brillan, con hasta 4,6× más velocidad que un M3 Ultra. La velocidad de generación, en cambio, depende del ancho de banda de memoria: el M5 Ultra entrega 1,2 TB/s frente a los 819 GB/s del M3 Ultra, lo que se traduce en 1,6× más tokens por segundo.
El efecto se ve mejor con modelos densos, donde todos los parámetros están activos:
| Modelo | TTFT M3 Ultra | TTFT M5 Ultra | Tokens/s M3 Ultra | Tokens/s M5 Ultra |
|---|---|---|---|---|
| Mistral Medium 3.5 (128B) | 95,9 s | 24,6 s | 4,95 | 7,70 |
| Qwen 3.8 (27B) | 18,2 s | 4,1 s | 12,46 | 19,69 |
Muse Spark Open es otro caso, porque no cabe en una sola máquina. En precisión nativa BF16 necesita más de 1,6 TB de memoria solo para los pesos; cuantizado a 4 bits (NVFP4) baja a unos 493 GB, y aun así el consumo extra durante la inferencia impide que entre en un único Mac Studio de 512 GB. Apple lo evaluó precisamente así, en NVFP4.
El consumo energético también cuenta: Apple reporta un pico de unos 200 W en el Mac Studio con M3 Ultra y de 300 W en el M5 Ultra. Es una fracción de lo que consume un tostador, y es lo que permite tener estas máquinas en una oficina o en una casa sin obra eléctrica.
Pipeline vs tensor: cómo se reparte un modelo entre varias Mac
Apple describe dos formas de paralelizar. La paralelización por pipeline divide el modelo por profundidad: un Mac Studio ejecuta las primeras capas y le pasa la salida al segundo, que ejecuta las siguientes. Es simple de implementar y la sobrecarga de comunicación es baja, porque solo se intercambian las salidas intermedias entre los dos bloques de capas.
La paralelización por tensor reparte el ancho del modelo: cada máquina guarda una fracción de cada capa y el cómputo se paraleliza dentro de la capa. Rinde más, pero exige comunicación constante y de bajísima latencia. Por eso MLX se apoya en RDMA sobre Thunderbolt, un driver de baja latencia que llegó con macOS 26.2 y que MLX usa desde la versión 0.30.1 mediante sus colectivos de comunicación jaccl.
Los resultados de Apple con Muse Spark Open, a 8.192 tokens de contexto y 128 tokens generados, muestran la progresión:
| Configuración | TTFT | Tokens/s |
|---|---|---|
| 2 Mac Studio, pipeline | 8,4 s | 15,74 |
| 2 Mac Studio, tensor | 8,2 s | 24,99 |
| 4 Mac Studio, tensor | 4,8 s | 36,73 |
Hay dos matices que Apple señala sin adornos. Primero: con pocas máquinas y contextos muy largos (65.536 tokens), la paralelización por tensor puede ser más lenta que la de pipeline en la fase de prefill por la sobrecarga de comunicación, algo que se nota en Muse Spark Open y desaparece al sumar máquinas. Segundo: los modelos densos escalan mejor entre computadoras que los MoE.
Apple también midió el efecto del cableado: en cuatro M5 Ultra y un contexto de 65.536 tokens, usar dos cables Thunderbolt por enlace bajó el TTFT de 50,5 s a 40,6 s. Es un detalle de infraestructura con impacto directo en la experiencia de uso.
¿Cuánto cuesta montarlo y cuándo conviene frente a la nube?
El Mac Studio con M5 Ultra arranca en US$5.499, según TechRepublic, y la configuración de 512 GB de memoria unificada —la que hace falta para este escenario— llegaría a finales de octubre con un precio que se espera bien por encima de los US$10.000, según la guía de compradores de MacRumors. El Wall Street Journal reportó que el hardware necesario para correr Muse Spark Open localmente supera los US$40.000, cifra que cita Tech Wire Asia.
Ese número hay que leerlo contra la alternativa de la nube. El acceso vía API a proveedores como Together AI o Fireworks AI tiene costo variable y cero mantenimiento; el clúster local tiene costo inicial alto, pero electricidad predecible y ningún dato saliendo de tu infraestructura. Ni Meta ni Apple publicaron una comparación de costos entre ambos caminos, así que la decisión depende de tu volumen real.
Hay un detalle legal que muchos pasan por alto. Muse Spark Open se distribuye bajo la Muse Model License, que permite uso comercial con condiciones: si ofreces el modelo como servicio a terceros y tu facturación bruta agregada supera los US$20 millones en 12 meses consecutivos, debes notificar a Meta y firmar un acuerdo aparte, según detalla Tech Wire Asia. Para uso interno o productos que no revenden el modelo, ese requisito no aplica.
¿Qué significa esto para tu startup?
La señal de fondo es que la inferencia de modelos grandes dejó de ser un servicio exclusivamente cloud y se volvió una decisión de arquitectura. Estas son las acciones concretas:
- Mide con tu contexto real antes de comprar hardware. El mismo modelo pasa de 8,4 s a 8,2 s de TTFT según la estrategia de paralelización, y las cifras cambian por completo entre 8.192 y 65.536 tokens. Usa mlx_lm.benchmark con la longitud de contexto de tus prompts reales, no con la del benchmark de Apple.
- Empieza por una sola máquina. Los modelos densos de 27B a 128B —como Qwen 3.8 y Mistral Medium 3.5— sí caben en un Mac Studio de 512 GB: Apple reporta hasta 68 GB y 158 GB de RAM ocupada respectivamente en contexto largo. Solo salta al clúster cuando necesites modelos que no entren en una caja.
- Revisa la licencia antes de construir un producto. Si tu plan de negocio es revender acceso al modelo, la cláusula de los US$20 millones de facturación cambia el encuadre legal de tu servicio. Leerla antes de diseñar el pricing es más barato que reescribir el contrato después.
- Acepta el costo operativo que la nube te ahorraba. Mantenimiento, actualizaciones de macOS y MLX, seguridad física y gestión de recursos pasan a ser tu responsabilidad. Mantener la inferencia en hardware propio no garantiza privacidad por sí solo: depende de cómo configures las aplicaciones y de si se conectan a servicios externos.
La oportunidad más inmediata no está en correr Muse Spark Open, sino en lo que habilita su capa de abajo: mlx_lm.server convierte el clúster en un endpoint compatible con herramientas de código agéntico como OpenCode, apuntando a http://127.0.0.1:8080/v1. Es decir, un equipo pequeño puede montar su propio stack de agentes sin enviar una línea de código propietario a un tercero.
Conclusión
Apple y Meta resolvieron un problema que hasta ahora era incómodo: los modelos abiertos de frontera exigían infraestructura de datacenter. Con MLX, RDMA sobre Thunderbolt y el M5 Ultra con hasta 512 GB de memoria unificada, un clúster de cuatro Mac Studio entrega 36,73 tokens por segundo con un modelo de 816B parámetros que nadie tendría que haber podido correr en una oficina.
Para un founder hispanohablante, la pregunta correcta no es si comprar el hardware, sino cuánto de su tráfico de inferencia justifica moverlo on-premise. Si tu volumen es bajo o irregular, las APIs siguen ganando. Si tu producto depende de datos sensibles, contextos largos y uso intensivo de agentes, el cálculo cambió: hoy existe una alternativa que no existía hace un año, y su punto de equilibrio se puede medir con una tarde de benchmarks.
Fuentes
- Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio (fuente original)
- Meta and Apple Bring Muse Spark Open AI Model to Mac Studio (MacRumors)
- Meta Releases Muse Spark Open AI Optimized for Mac Studio (iClarified)
- Meta and Apple team up to run Muse Spark Open AI locally on Macs (Tech Wire Asia)
- Mac Studio 2026: Apple Goes All In on Local AI With M5 Ultra (TechRepublic)
- Mac Studio Buyer's Guide: M5 Max vs. M5 Ultra (MacRumors)
- Review: Apple's hyper-pricey M5 Ultra Mac Studio made me into a vibe coder (Ars Technica)
Leíste lo que hace la IA. ¿Y en tu negocio?
En CAR, dueños de empresa arman en 7 días su primer sistema funcionando: que ningún cliente se les escape, o que el informe del lunes salga solo. Con otros emprendedores al lado.
👥 Probar 7 días