El problema dual-write que rompe arquitecturas distribuidas
Tu servicio confirma un pedido en la base de datos, publica un evento OrderCreated y, antes de que el broker responda, el proceso muere. El pedido existe. Inventario, facturación y envíos nunca se enteraron. Ese es el problema dual-write: una parte de la operación se ejecuta y la otra no, dejando servicios aguas abajo permanentemente desincronizados. Y es el fallo silencioso que más caros sale a las startups que escalan hacia arquitecturas orientadas a eventos.
El patrón transactional outbox existe precisamente para hacer que ese escenario sea imposible. Si tu sistema actualiza una base de datos y publica eventos en pasos separados, tienes una bomba de relojería esperando el próximo deploy, la próxima caída de red o el próximo timeout.
Qué es el patrón transactional outbox
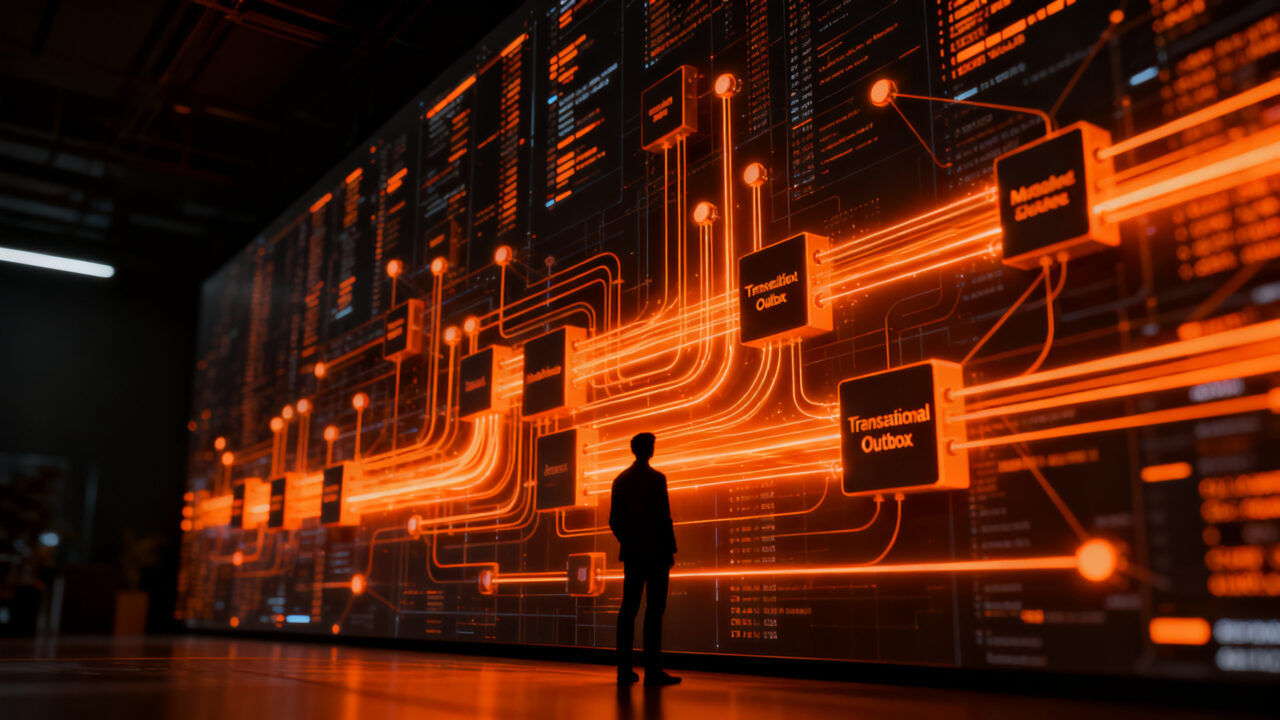
La idea es directa: en lugar de escribir los datos de negocio en una tabla y publicar el evento al broker en dos pasos distintos, la aplicación escribe ambos registros en la misma transacción de base de datos. Si la transacción confirma, los dos quedan guardados. Si falla, ninguno queda.
👥 ¿Quieres ir más allá de la noticia?
En nuestra comunidad discutimos las tendencias, compartimos oportunidades y nos ayudamos entre emprendedores. Sin humo, solo acción.
👥 Unirme a la comunidadEl evento no se publica al instante. Se almacena en una outbox table junto con los datos de negocio. Un componente separado, llamado message relay, lee esa tabla y publica cada evento al broker. Si el broker está caído, el relay reintenta. Como el evento ya está persistido de forma segura en la base de datos, reintentar no arriesga inconsistencia: solo retrasa la entrega hasta que el broker vuelve a estar disponible.
Este patrón se popularizó como parte del catálogo de arquitecturas de microservicios y hoy se considera fundacional para cualquier sistema donde los servicios dependen de entrega confiable de eventos para mantenerse coordinados, según la guía sobre microservicios event-driven publicada por Adam Bellemare de Confluent en InfoWorld.
Cuándo lo necesitas (y cuándo no)
El outbox no es una elección por defecto. Lo necesitas cuando:
- Dos o más servicios deben reaccionar a la misma operación de negocio (pedido creado → inventario, facturación, envíos).
- Usas un broker como Kafka, RabbitMQ o Redis Streams.
- No toleras pérdida silenciosa de eventos (fintech, logística, salud, integraciones B2B).
- Tu aplicación escribe en una base de datos relacional con soporte transaccional.
Probablemente no lo necesitas cuando:
- Tienes una aplicación monolítica sin comunicación entre servicios.
- Puedes tolerar consistencia eventual con retardos largos.
- Tu equipo es pequeño y el sistema es lo bastante simple para que el polling directo desde los consumidores sea suficiente.
Las dos estrategias del message relay
La outbox table garantiza que el evento queda registrado. El message relay garantiza que efectivamente llega al broker. Hay dos formas comunes de detectar filas nuevas:
- Polling. El relay consulta la outbox table a intervalos regulares (cada pocos segundos, por ejemplo) y publica las filas no procesadas. Más fácil de implementar, menos infraestructura, latencia ligeramente mayor. Para muchos equipos es el punto de partida correcto.
- Change Data Capture (CDC). Lee directamente el transaction log de la base de datos y emite nuevos registros a medida que se confirman. Menor latencia, pero requiere infraestructura adicional como Debezium o un servicio CDC gestionado. Es el camino de migración natural cuando crece el throughput.
Para la mayoría de startups, polling con un trigger de PostgreSQL o un Schedule Trigger en una plataforma de automatización como n8n es la ruta más rápida hacia fiabilidad de producción.
Cómo construir el relay en n8n
n8n es una plataforma de automatización de workflows fair-code fundada en Berlín en 2019. Según una nota reciente de The Next Web, la herramienta cuenta con más de 230.000 usuarios activos, más de 3.000 clientes enterprise (incluyendo Microsoft, KPMG, Vodafone, Volkswagen, Decathlon y Twitch), 183.000 estrellas en GitHub y un ARR de US$40M creciendo 10 veces interanual. En 2026 SAP integró n8n dentro de Joule Studio como capa de orquestación para su plataforma Autonomous Enterprise, en una operación que valoró a la compañía en US$5.200M.
Para construir el message relay, el workflow tiene cinco bloques:
- Detectar filas nuevas en la outbox: usa un nodo Postgres Trigger para reaccionar a filas en tiempo real, o un nodo Schedule Trigger para hacer polling cada N segundos.
- Publicar cada evento: envía el evento a tu broker (RabbitMQ, Redis, Kafka) o servicio downstream. n8n soporta varios brokers de forma nativa y, para cualquier otro, puedes usar el nodo HTTP Request con reintentos integrados.
- Marcar filas como procesadas: solo actualiza la outbox table para marcar una fila como procesada después de que el broker confirme recepción. Marcarla antes reintroduce el problema dual-write.
- Alertar en fallos de entrega: usa un workflow con Error Trigger para notificar al equipo cuando se agotan los reintentos. Los eventos fallidos no pueden pasar desapercibidos.
- Revisar el historial de ejecución: n8n guarda cada ejecución del workflow, así puedes auditar cada ciclo del relay para confirmar entregas o diagnosticar fallos.
Este enfoque te permite llevar un relay de grado producción a producción sin escribir ni mantener un servicio worker personalizado.
Checklist de producción: lo que tu implementación no puede saltarse
El patrón solo funciona si cada pieza del pipeline está diseñada para fallar. Errores comunes que anulan la garantía:
- Escribe eventos y datos de negocio en la misma transacción. Insertar el registro en la outbox después de hacer commit de la transacción de negocio reintroduce el problema dual-write.
- Marca como procesado solo tras entrega confirmada. Espera el ACK del broker antes de actualizar la fila en la outbox.
- Diseña consumidores idempotentes. Incluso con reintentos, la entrega duplicada siempre es posible. Los consumidores deben poder procesar el mismo evento más de una vez sin corromper estado.
- Elige la estrategia de relay correcta. Polling es el default simple; CDC es la mejora para cuando la latencia empieza a doler.
- Monitoriza filas estancadas. Configura alertas para outbox rows que lleven más tiempo del esperado sin procesarse. Una cola silenciosa es peor que una cola vacía.
- Archiva eventos procesados. Limpia o archiva filas antiguas para que la tabla no crezca sin límite.
- Preserva el orden cuando importa. Si los consumidores aguas abajo dependen de secuencia, diseña el relay para publicar en orden de commit bajo carga concurrente.
Qué significa esto para tu startup
Si tu arquitectura actual todavía publica eventos llamando directamente al broker desde el código de aplicación, tienes un bug latente que tarde o temprano va a detonar. El patrón transactional outbox es la solución estándar, y la sobrecarga operativa para implementarlo es hoy lo bastante baja como para no necesitar un equipo de plataforma dedicado.
Tres acciones concretas que puedes tomar esta semana:
- Audita tus write paths actuales. Identifica cada punto donde tu aplicación hace commit en base de datos y publica a un broker o sistema externo. Cada uno es un dual-write potencial.
- Añade una outbox table a tu base de datos existente. Con al menos:
event_id(UUID),aggregate_id,payload(JSON),created_at,processed_at. Escribe en ella dentro de la misma transacción que tus datos de negocio. - Construye el relay en n8n. Usa los nodos Postgres Trigger o Schedule Trigger para leer la outbox y publicar a tu broker. Configura un workflow con Error Trigger para fallos de entrega y un job de limpieza que archive filas procesadas con más de 30 días.
El patrón no es teórico: sostiene sistemas en producción que procesan miles de millones de eventos diarios. Las herramientas para implementarlo son hoy accesibles a un equipo de dos ingenieros con una plataforma de automatización fair-code, sin equipo de plataforma dedicado.
Fuentes
- How the Transactional Outbox Pattern Guarantees Event Delivery (fuente original)
- How to get started with event-driven microservices - InfoWorld
- A Berlin side project just became the orchestration layer of SAP's AI platform - The Next Web
👥 ¿Quieres ir más allá de la noticia?
En nuestra comunidad discutimos las tendencias, compartimos oportunidades y nos ayudamos entre emprendedores. Sin humo, solo acción.
👥 Unirme a la comunidadArtículos relacionados:
 Relay cierra y su CEO se une a Google Chrome: lección para founders
 WebKit 2026: 3 vulnerabilidades filtran tu IP en iCloud Private Relay
 Relay: cowork de IA open-source para gestionar agentes autónomos
 Índice de acceso bancario: 19 bancos de EE.UU. para no residentes
 Cementerio de la IA: startups y proyectos que no sobrevivieron