Qué cambió en los logs de Vercel AI Gateway
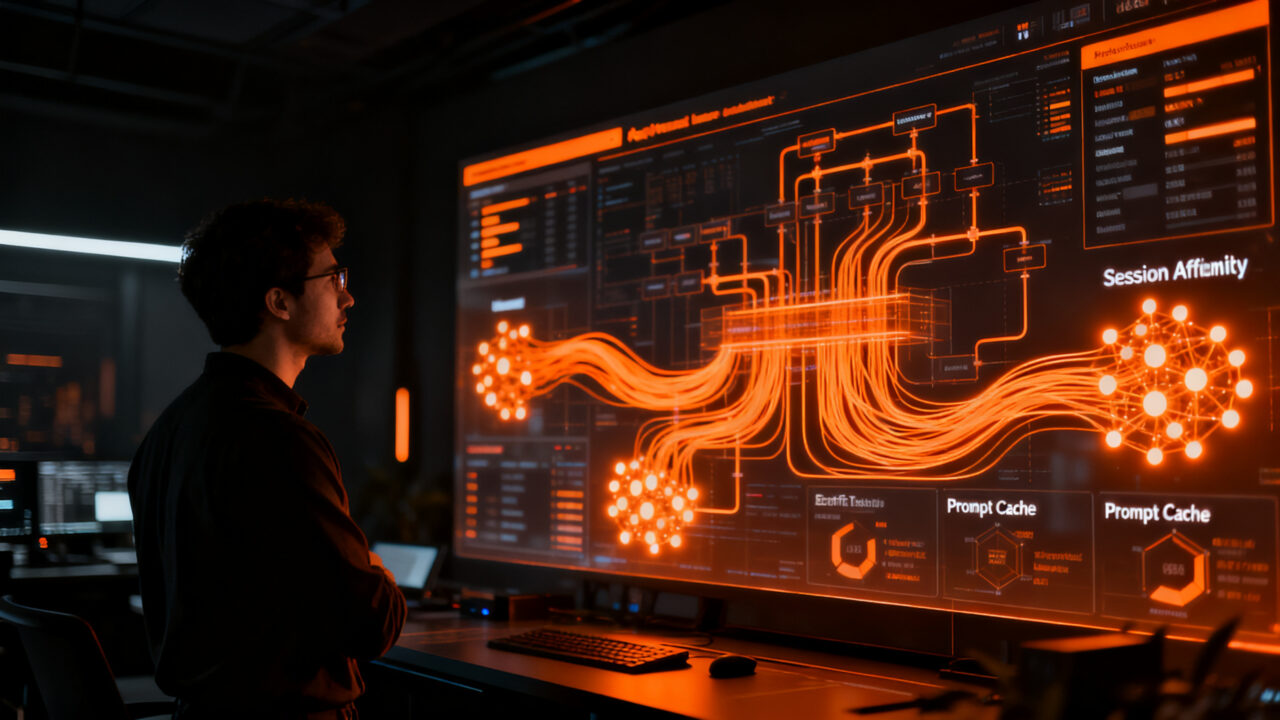
Vercel agregó una vista de Sessions a los logs de su AI Gateway: ahora las peticiones se agrupan en sesiones y se muestra cómo la session affinity enrutó cada una. Cada fila indica el agente de código o la app que corrió la sesión —Claude Code, Codex o Cursor, por ejemplo— junto con su costo, los modelos y proveedores usados, y qué porción del input se leyó desde caché en cada turno.
Para un founder que ya paga facturas de LLM todos los meses, esto no es una mejora cosmética de dashboard. Es la primera vez que el costo de un agente se puede mirar por conversación y no por llamada suelta.
Por qué la session affinity importa para tu factura de IA
El problema que resuelve la afinidad de sesión es concreto: en una conversación multi-turno, cada turno reenvía el historial completo. Si cada turno cae en un proveedor distinto, ese proveedor arranca en frío y reprocesa todo el prompt desde cero.
Leíste lo que hace la IA. ¿Y en tu negocio?
En CAR, dueños de empresa arman en 7 días su primer sistema funcionando: que ningún cliente se les escape, o que el informe del lunes salga solo. Con otros emprendedores al lado.
👥 Probar 7 díasLa session affinity hace lo contrario: envía cada turno al proveedor que sirvió el turno anterior, de modo que ese proveedor ya tiene la mayor parte del prompt en caché. Una sesión que se mantiene en un solo proveedor lee más de cada prompt desde caché, y eso se traduce directamente en menos cómputo facturado.
El respaldo de este mecanismo viene de la industria. TechCrunch reportó en diciembre de 2024 que el caching de prompts de AWS Bedrock puede reducir el costo hasta un 90% y la latencia hasta un 85%, y que Adobe, tras probarlo en algunas de sus aplicaciones de IA generativa, vio una reducción del 72% en el tiempo de respuesta.
La magnitud del ahorro depende del caso de uso. Un análisis de Geeky Gadgets sobre técnicas de KV caching señala que este método puede recortar costos en un rango de 41% a 80% según el escenario, con especial valor en tareas repetitivas o flujos con prompts consistentes.
Cómo funciona la afinidad de sesión (y cómo controlarla)
La afinidad corre por defecto en peticiones de texto y chat. Para agrupar peticiones manualmente, hay que enviar el mismo sessionId en providerOptions.gateway, o el mismo header x-session-id, en cada request de una conversación.
Las peticiones que no traen identificador se agrupan por una huella del inicio de la conversación y aparecen como sesiones fingerprintadas. Ese detalle importa: si tu app no propaga un sessionId estable, igual vas a ver sesiones agrupadas, pero no vas a poder garantizar la continuidad de proveedor que hace rendir la caché.
Al abrir una sesión individual se ve su cache hit rate, duración y ruta. La ruta lista cada turno con su modelo y su timing, y nombra al proveedor que sirvió la sesión junto con los anteriores. Es, en la práctica, un mapa de cómo se movió tu conversación entre proveedores y cuánto de cada prompt se recuperó de caché.
Los filtros disponibles son por turnos, cliente, modelo, proveedor, autenticación o costo. Las sesiones de un solo turno quedan ocultas hasta que se limpia el filtro de turnos mínimos —un default sensato, porque una sesión de un turno no tiene afinidad que mostrar.
Qué dicen los datos del propio Vercel
El contexto de escala ayuda a entender por qué Vercel está invirtiendo aquí. En su conferencia Ship, la compañía dijo que a comienzos del año menos del 3% de los despliegues en su plataforma eran disparados por agentes de código, y que ahora los agentes explican más de la mitad de todos los commits, según reportó SiliconANGLE en junio de 2026.
En el mismo evento, Vercel señaló que el volumen de tokens a través de su AI Gateway creció de aproximadamente 2 millones a 20 millones en ese periodo, a medida que se multiplicaron los agentes de IA. El fundador y CEO Guillermo Rauch lo resumió así: cada generación de software necesita una generación de infraestructura, y para la era de los agentes esa infraestructura es Vercel.
Ese crecimiento es exactamente el motivo por el que la observabilidad de costos se volvió un problema de producto y no de soporte. Cuando el tráfico se multiplica por diez y cada sesión tiene decenas de turnos, un punto porcentual de cache hit rate deja de ser un detalle técnico.
El resto del mercado se mueve en la misma dirección
Vercel no está solo. AWS combinó caching con prompt routing en Bedrock, enviando consultas simples a modelos más baratos dentro de la misma familia. Y el 14 de octubre de 2026, Tensormesh —el equipo detrás del proyecto open source LMCache— anunció su plataforma para gestionar la reutilización de KV cache en infraestructura propia, según Unite.ai.
Ese anuncio trae un dato útil para calibrar expectativas: el paper de CacheBlend, presentado en EuroSys 2025, reporta entre 2,2 y 3,3 veces más velocidad en el tiempo hasta el primer token y entre 2,8 y 5 veces más throughput frente al recómputo completo del KV cache en las cargas evaluadas. Son resultados de investigación bajo condiciones específicas, no un ahorro garantizado, pero marcan el orden de magnitud de lo que está en juego.
La conclusión de sector es clara: el costo de inferencia dejó de ser un problema de elegir el modelo más barato y pasó a ser un problema de arquitectura de reutilización.
¿Qué significa esto para tu startup?
Si construyes con agentes, la caché dejó de ser un detalle de infraestructura y se volvió una línea de tu P&L. Tres cosas concretas para hacer esta semana:
- Propaga un
sessionIdestable en toda tu app. Si dejas que Vercel agrupe por huella del inicio de la conversación, pierdes control sobre la continuidad de proveedor. Enviar el mismosessionIdenproviderOptions.gatewayo el headerx-session-iden cada request es la diferencia entre una caché que rinde y una que no. - Abre tus sesiones más caras y mira el cache hit rate antes que el costo total. El filtro por costo te lleva directo a las sesiones que más gastan; la ruta de turnos te dice si el problema es el volumen de uso o la falta de reutilización. Si una sesión salta entre proveedores, ahí está tu ahorro.
- No cambies de modelo ni de herramientas a mitad de sesión. Las prácticas recomendadas de caching apuntan a elegir el modelo al inicio de la sesión y evitar agregar o quitar herramientas en el medio, porque eso invalida la caché y obliga a reconstruirla.
Un cuarto punto, menos obvio: mide el cache hit rate como métrica de producto, no solo de infraestructura. Un agente con buen hit rate responde más rápido y cuesta menos con el mismo prompt. Eso es retención de usuario y margen en la misma línea del dashboard.
Fuentes
- AI Gateway logs now show session affinity
- Vercel launches a new framework and enterprise controls for agentic AI infrastructure
- AWS brings prompt routing and caching to its Bedrock LLM service
- Tensormesh Launches Platform to Cut LLM Inference Costs Through KV-Cache Reuse
Leíste lo que hace la IA. ¿Y en tu negocio?
En CAR, dueños de empresa arman en 7 días su primer sistema funcionando: que ningún cliente se les escape, o que el informe del lunes salga solo. Con otros emprendedores al lado.
👥 Probar 7 díasArtículos relacionados:
 Vercel abre el backend: Python GA, contenedores y Daemons
 Hermes Agent con Vercel: 200+ modelos IA sin markup para startups 2026
 Vercel Sandbox migra a Managed Images: menos configuración, más seguridad para startups
 Vercel presenta Fluid: compute que se adapta a cada agente
 Plugin Vercel para Claude Code: privacidad y telemetría