TorchNeuron: PyTorch nativo en Trainium, sin pensar como un compilador
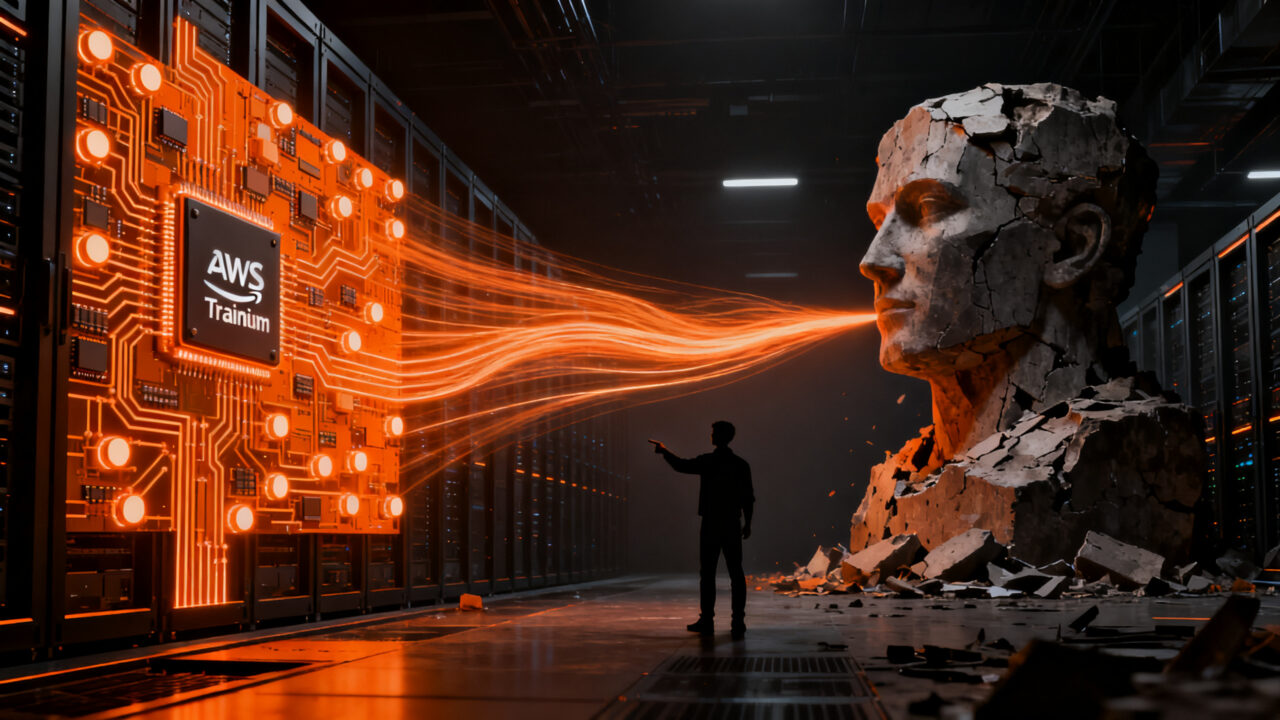
El 89% de las 100 arquitecturas de generación de texto más usadas ya corre sobre AWS Trainium sin código específico para el chip, frente al 46% que cubría Optimum Neuron v0.4.5. Esa brecha es el resumen de TorchNeuron, el plugin de PyTorch que integra los aceleradores de Amazon como un dispositivo nativo dentro del framework.
Para un equipo que entrena o sirve modelos, la diferencia es concreta: portar un modelo a Trainium dejó de ser una reescritura de semanas y, en el caso más simple, se resuelve con una línea de configuración.
Hasta ahora, la experiencia de Hugging Face en Trainium e Inferentia —chips diseñados por AWS para entrenamiento e inferencia de bajo costo a escala— se entregaba a través de optimum-neuron. Esa librería se apoyaba en torch-neuronx sobre PyTorch XLA: la opción natural en su momento, pero obligaba a pensar como un compilador. Tensores lazy en lugar de ejecución eager, solo formas estáticas y una recompilación por cada graph break. Optimum Neuron existía justamente para esconder esa complejidad, y para lograrlo mantenía código propio: clases de modelado, trainers y demás.
Leíste lo que hace la IA. ¿Y en tu negocio?
En CAR, dueños de empresa arman en 7 días su primer sistema funcionando: que ningún cliente se les escape, o que el informe del lunes salga solo. Con otros emprendedores al lado.
👥 Probar 7 díasQué cambia cuando Trainium es un dispositivo nativo de PyTorch
TorchNeuron se integra directamente en PyTorch y expone neuron como device. Con eso llegan tres cosas que antes no existían en Trainium:
- Ejecución eager, sin tensores lazy.
- Primitivas distribuidas nativas de PyTorch: DTensor y FSDP2.
- torch.compile con backend de Neuron.
Para las librerías de Hugging Face, Trainium pasa a ser un dispositivo como cualquier otro: Transformers, Diffusers, Accelerate, PEFT y TRL corren directo, con las mismas clases y los mismos scripts que usarías en otro acelerador. La recomendación oficial del equipo de Hugging Face es dejar de pasar por Optimum Neuron y usar estas librerías de forma directa.
La beta pública abre el 20 de octubre de 2026 y se instala con pip install torch-neuronx. Según CryptoBriefing, el anuncio lo hizo Amazon el 19 de octubre, el desarrollo está a cargo de Annapurna Labs, la división responsable de sus chips personalizados, y se liberó bajo licencia Apache 2.0 en el marco de la PyTorch Conference en San José. La misma cobertura señala que las acciones de Amazon subieron hasta un 5% intradía tras el anuncio y que más de 30 clientes tempranos ya lo usan en robótica, voz y descubrimiento de fármacos. Colin Brace, VP de software de Annapurna Labs, puso el ahorro de costos como la razón central para mirar Trainium.
Cómo se ve en el código, sin reescribir nada
Para inferencia alcanza con pasar device_map=neuron y el modelo se mueve a los dispositivos Neuron. Con tensor parallelism, el patrón es declarar un DistributedConfig con el tp_size, armar un DeviceMesh y usar un cache estático en la generación para evitar recompilaciones frecuentes.
En entrenamiento el cambio es todavía más notorio. Un script estándar de fine-tuning con TRL corre en Trainium con apenas unos ajustes específicos del backend. Se define un DistributedConfig con los tamaños de tensor parallel (TP) y FSDP, el SFTTrainer lo pasa a from_pretrained y el modelo queda shardeado mientras se cargan los pesos. El Trainer detecta que el modelo ya está distribuido y no lo vuelve a envolver: no hace falta un flag --fsdp ni una configuración de FSDP en Accelerate.
Tres detalles prácticos de la ejecución en Trainium:
- Formas estáticas. El script desactiva las formas dinámicas automáticas de torch.compile y usa packing para producir secuencias de hasta 2.048 tokens. Con TRL 1.16 o superior, los batches en Neuron se rellenan a múltiplos de 128 tokens, lo que limita la cantidad de formas de entrada y permite reutilizar los grafos compilados.
- torch.compile activado. Basta con
--torch_compile true: en una instancia Trainium, torch.compile detecta el dispositivo y elige el backend de Neuron solo. - Carga asíncrona de pesos desactivada. El cargado asíncrono integrado en Transformers no está soportado en Neuron, así que por ahora se desactiva con
HF_DEACTIVATE_ASYNC_LOAD=1.
La configuración de referencia del ejemplo se corrió sobre 8 chips Trainium2 (32 NeuronCores), la mitad de una instancia trn2.48xlarge, con una grilla de 4 x 8: tensor parallelism reparte cada capa entre los 4 cores de un grupo TP y FSDP shardea parámetros, gradientes y estado del optimizador entre los 8 grupos. El checkpoint final es un checkpoint estándar de Transformers: se puede subir al Hub y cargar en cualquier otro hardware.
En difusión, varios pipelines de Diffusers ya son compatibles en modo eager y compilado, incluidos FLUX.1-dev, FLUX.2, Qwen-Image, Qwen-Image-2.1 y H3, con soporte de tensor parallelism para aprovechar los dispositivos Neuron.
El verdadero campo de batalla es la factura de cómputo
El movimiento de Amazon se entiende mejor mirando el precio del cómputo ajeno. Según Investing.com, AWS subió cerca de un 20% las tarifas de reserva de instancias GPU para machine learning a partir del 1 de julio de 2026, con tarifas por acelerador y por hora que van de US$5.191 en la familia P5 en Estados Unidos a US$12.355 en la P6-B200 y US$14.04 en la P6-B300. La misma cobertura señala que AWS facturó US$37.600 millones en el primer trimestre de 2026, un 28% más interanual y su mayor crecimiento en más de tres años, y que Reuters reportó en marzo de 2026 que Amazon recibirá 1 millón de chips Nvidia hacia fines de 2027.
Frente a ese escenario, cada workload que se mueve a Trainium deja de consumir silicio que Amazon le compra a un tercero. Nvidia concentra entre el 70% y el 80% del mercado de chips de IA por ingresos, según TechTimes, pero su ventaja más resistente es de software: CUDA y los años de código y flujos de trabajo construidos alrededor. La apuesta de TorchNeuron es empujar ese costo de cambio hacia cero.
La dirección del mercado acompaña. TechTimes cita datos de TrendForce según los cuales los envíos de aceleradores de IA personalizados crecerían un 44,6% en 2026, alrededor de tres veces el 16,1% proyectado para las GPU de propósito general. El mismo análisis sostiene que, a escala de producción, los chips de inferencia diseñados a medida entregan reducciones de costo por token de entre 50% y 67%, y menciona que el chip Jalapeño de OpenAI, desarrollado con Broadcom, mostró en pruebas iniciales un ahorro cercano al 50% por token frente a la inferencia en GPU estándar.
El contexto histórico refuerza la tendencia: el costo por consulta de un modelo equivalente a GPT-3.5 cayó de unos US$20 por millón de tokens en noviembre de 2022 a US$0.07 por millón en octubre de 2024, según el AI Index 2025 de Stanford HAI citado por TechTimes. Esa curva no la movió el silicio más rápido, sino la optimización conjunta de hardware y software.
Qué significa esto para tu startup
- Haz el benchmark con tu propio modelo antes de decidir. El argumento de Annapurna Labs es el ahorro de costos, pero el número que importa es el tuyo: costo por millón de tokens y latencia en tu caso de uso real. Con TorchNeuron, probar Trainium ya no exige reescribir el script, así que el experimento es barato y reversible.
- Si hoy usas optimum-neuron, planifica la migración. La recomendación de Hugging Face es usar directamente Transformers, Accelerate, PEFT y TRL. Antes de mover producción, revisa tres puntos: las formas estáticas de tu pipeline, la variable
HF_DEACTIVATE_ASYNC_LOAD=1y el layout de paralelismo (TP x FSDP = número de procesos = NeuronCores disponibles). - Diseña pensando en la portabilidad. El checkpoint que sale de un entrenamiento en Trainium es un checkpoint estándar de Transformers y el mismo script corre en cualquier hardware. Eso cambia tu posición al negociar con un proveedor de nube: experimentas sin quedar casado con un acelerador.
- Presupuesta el tiempo de adaptación, no solo el del chip. El backend es una beta pública y el ecosistema de kernels de Neuron, escritos con NKI y publicados en el Hub, todavía es joven aunque crece rápido. El propio anuncio menciona un kernel disponible que acelera vision transformers hasta 2,4x en Trainium.
Limitaciones que conviene conocer antes de migrar
- TorchNeuron se libera como beta pública: úsalo para experimentar y medir, no como apuesta de producción sin pruebas.
- El backend todavía no puede compilar las formas dinámicas automáticas de Dynamo dentro de torch.compile, un punto que el propio ejemplo de entrenamiento documenta como limitación abierta.
- Las formas estáticas siguen siendo la regla: cache estático durante la generación, packing y relleno de batches a múltiplos de 128 tokens con TRL 1.16 o superior.
- La carga asíncrona de pesos no está soportada, y esa función se desactiva por ahora.
- En Diffusers, el tensor parallelism cubre por el momento FLUX.1-dev, FLUX.2, Qwen-Image, Qwen-Image-2.1 y H3. Si tu pipeline no está en la lista, el proyecto publicó una guía para agregar soporte.
Conclusión
Amazon no está vendiendo silicio: está comprando la decisión del desarrollador. Durante años, la defensa real de Nvidia no fue el chip más rápido sino el costo de migrar el código, y TorchNeuron ataca justo ese punto. Que el mismo script de fine-tuning con TRL corra en Trainium, en una GPU o en otro acelerador convierte al hardware en una variable de tu presupuesto y no en una decisión de fe.
Para un founder, la lectura práctica es que el cómputo de IA entró definitivamente en la etapa de negociación. Si tu producto depende de servir modelos a escala, la pregunta ya no es qué chip es mejor en abstracto, sino cuánto cuesta tu caso de uso concreto en cada uno. La buena noticia es que, por primera vez, responderla dejó de llevarse semanas de ingeniería.
Fuentes
- TorchNeuron: running HF models on AWS Trainium is easier than ever — Hugging Face Blog (fuente original)
- Amazon unveils TorchNeuron to make its Trainium AI chips easier to use — CryptoBriefing
- AWS raising GPU instance prices 20% on July 1 — Investing.com vía Yahoo Finance
- Anthropic Confirms In-House Chip Team: Co-Design Bet Could Cut Claude Inference Costs in Half — TechTimes
Leíste lo que hace la IA. ¿Y en tu negocio?
En CAR, dueños de empresa arman en 7 días su primer sistema funcionando: que ningún cliente se les escape, o que el informe del lunes salga solo. Con otros emprendedores al lado.
👥 Probar 7 días