Un agente bien afinado no escala: el problema es la coordinación
Un sistema multiagente puede consumir 15 veces más tokens que una conversación de chat convencional y, aun así, bajar el costo por transacción en flujos complejos. Lo señala un análisis publicado en Forbes por Dhruv Roongta, CTO de la startup Slashy. Para un founder que define hoy si su producto lleva uno o cinco agentes, esa contradicción aparente es la decisión de arquitectura más cara del año.
La lógica de fondo es la misma que aplicas cuando partes el código en funciones: un agente único que hace retrieval, razonamiento de dominio, validación y formateo en un solo prompt tiende a hacer las cuatro cosas un poco peor que cuatro agentes haciendo una cada uno. Menos responsabilidad por agente significa un system prompt más corto, comportamiento más predecible y evaluación más simple.
El problema llega después. En el momento en que hay más de un agente, aparece un problema de coordinación encima del problema de razonamiento, y ahí se consume casi todo el esfuerzo real de ingeniería. Las demos no lo muestran porque están diseñadas para funcionar una vez, no para correr seis meses contra inputs que nadie anticipó.
Leíste lo que hace la IA. ¿Y en tu negocio?
Un agente de IA puede quedarse con parte de tu día: ordenar lo pendiente y pedirte el OK antes de actuar. El Kit «tu mano derecha con IA» trae un video de 11 minutos y una ficha para dejar al tuyo trabajando. CAR está cerrada por ahora; al anotarte, te avisamos cuando abra.
👥 Quiero el Kit →Los tres patrones de arquitectura multiagente
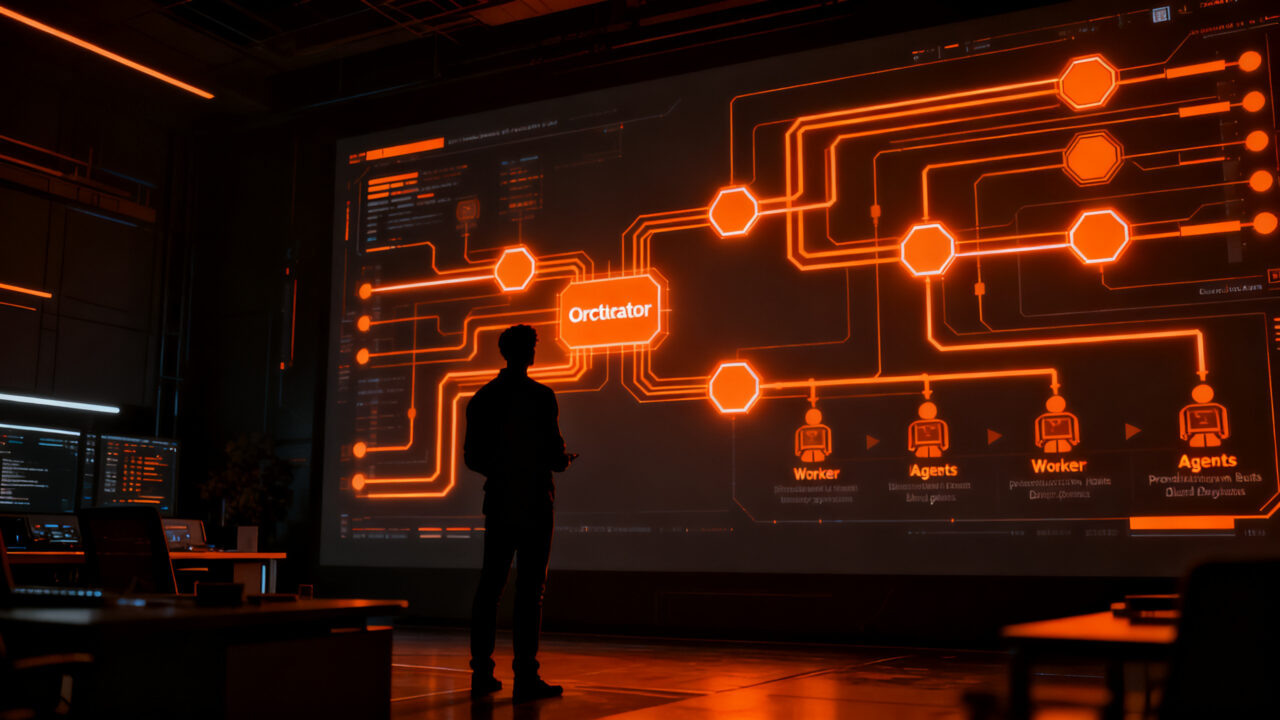
Orchestrator-Worker: el manager que reparte el trabajo
Un agente orquestador recibe la tarea, la descompone en subtareas, despacha cada una a un worker especializado y agrega los resultados. Los workers no se hablan entre sí: solo hablan con el orquestador.
Encaja cuando la descomposición es clara de antemano. Sabes que responder requiere buscar algo, generar algo y verificarlo, aunque no conozcas los detalles hasta runtime. El orquestador solo planifica y agrega, así que su prompt se mantiene chico y su comportamiento, predecible.
El trade-off es que se convierte en cuello de botella: todo el contexto pasa por él y, si juzga mal la descomposición, cada worker aguas abajo hereda el error.
Blackboard: cuando el camino no se conoce de antemano
El patrón blackboard elimina la jerarquía estricta. Los agentes leen y escriben sobre un estado compartido, el pizarrón, y cada uno decide cuándo tiene algo útil que aportar. Suele haber un scheduler liviano que define quién actúa a continuación según lo que hay en el pizarrón, pero ningún agente es dueño del plan.
Es el patrón para problemas donde la ruta de solución no se puede escribir antes de empezar: depurar un incidente sutil en producción, por ejemplo, donde un agente propone una hipótesis, otro reúne evidencia a favor o en contra y un tercero critica el razonamiento.
El precio de esa flexibilidad es que estos sistemas son mucho más difíciles de razonar y de testear. No hay un lugar único donde viva el plan, así que depurar un mal resultado implica reconstruir toda la secuencia de lecturas y escrituras después del hecho: más parecido a depurar una condición de carrera que a leer un stack de llamadas.
Pipeline: el default cuando el flujo ya se entiende
Una secuencia fija de agentes especializados, cada uno entregando su salida al siguiente: recuperar, extraer, validar, formatear. Sin lógica de delegación ni espacio compartido.
Es el más fácil de evaluar de los tres, porque cada etapa tiene un contrato de entrada y salida bien definido: puedes testear y versionar cada agente por separado. La limitación es la rigidez. Si la tarea no se descompone en una secuencia fija, o si el paso tres a veces necesita volver al paso uno, el pipeline falla o terminas agregando ramificaciones ad hoc hasta que se convierte en un orquestador con pasos extra.
Cómo elegir el patrón: tres preguntas
- Si puedes escribir la descomposición como un checklist antes de empezar, usa pipeline.
- Si la descomposición es conocible pero los detalles dependen del input, usa orchestrator-worker.
- Si no puedes saber la ruta hasta que los agentes empiecen a encontrar cosas, usa blackboard, y presupuesta más tiempo de evaluación.
Los fallos que solo aparecen en producción
- Bucles infinitos de delegación. Dos agentes que pueden decidir que la tarea no les corresponde y devolverla se la pasarán de ida y vuelta indefinidamente. Ninguno está equivocado en aislamiento: el bucle solo existe a nivel de sistema, y por eso es invisible cuando testeas agentes de a uno.
- Costo desbocado por re-invocación. Cada llamada entre agentes es una llamada a un modelo, y las llamadas cuestan dinero y tiempo. Un sistema blackboard con tres agentes re-chequeando el pizarrón después de cada escritura puede escalar a decenas de llamadas para una tarea que un humano resolvería en tres pasos. En desarrollo no se nota; en la factura, sí.
- Escrituras concurrentes en conflicto. Dos workers actualizando el mismo registro, o dos agentes blackboard intentando resolver la misma pregunta abierta, producen la misma clase de bug que una condición de carrera sin protección. La diferencia es que los escritores son modelos de lenguaje, lo que hace mucho más difícil reproducirlo de forma confiable.
- Propagación de errores entre agentes. El más insidioso. Si el Agente A alucina un dato y le pasa su salida al Agente B, B no tiene forma de distinguir esa alucinación de un hecho verificado: solo ve texto en su ventana de contexto y razona sobre él como si fuera cierto. En un sistema de un solo agente, una alucinación es una respuesta incorrecta. En uno multiagente, es un input que se compone con cada agente aguas abajo que confía en él.
Guardrails que funcionan: límites duros en código
Ninguno de estos fallos se resuelve con mejores prompts. Se resuelven con límites duros aplicados en código, fuera del control de los agentes.
- Tope de profundidad de delegación. Lleva la cuenta de cuántas veces se re-delegó una tarea y rechaza nuevas delegaciones pasado un límite fijo: entre 3 y 5 saltos es el rango razonable. Cuando se toca el techo, escala en lugar de iterar.
- Presupuesto de tokens o costo por tarea. Define un techo duro de tokens o de dólares por tarea, medido de forma central y no por agente. Cuando la tarea lo alcanza, se detiene: no tiene un intento más.
- Ruta de escalado humano. Cuando la confianza es baja o se toca un tope, el sistema necesita una salida real que no sea dejar que los agentes sigan intentando: mostrar el estado parcial a una persona en lugar de reintentar en silencio hasta producir una respuesta de baja calidad presentada como segura.
Qué significa esto para tu startup
Empieza por el pipeline y sube de complejidad solo cuando el pipeline se rompa. Es el patrón más barato de testear y el que mejor tolera que tu equipo todavía no tenga infraestructura de evaluación. Migrar a orchestrator-worker después es mucho más simple que depurar un blackboard que nunca debiste construir.
Instrumenta el costo por tarea desde el día uno. El dato más útil que vas a tener no es la latencia promedio, sino cuánto cuesta cada tarea resuelta y cuántas llamadas al modelo consumió. Sin esa métrica no puedes poner un techo, y sin techo el modo de fallo más común, la re-invocación desbocada, te llega por la factura.
Trata la alucinación como un problema de contrato entre agentes, no de prompt. Si un agente valida la salida de otro, ese validador necesita una fuente externa contra la cual contrastar, no solo el texto que recibió. La regla práctica: los hechos se verifican con herramientas, no con el modelo.
Construye observabilidad antes de escalar. Los fallos de coordinación que matan despliegues multiagente suelen ser invisibles en los logs, según el análisis de Forbes. Necesitas trazabilidad que muestre cómo interactúan los agentes, dónde fallan los handoffs y por qué se forman los bucles.
El contexto: los agentes ya son infraestructura
La discusión dejó de ser teórica. Según el análisis de Forbes, el mercado de sistemas multiagente pasaría de US$5.400M en 2024 a US$236.000M en 2034, y McKinsey proyecta entre US$450.000M y US$650.000M de ingresos anuales adicionales para 2030. En la misma línea, Microsoft informó que ya hay más de 50 millones de agentes registrados en su plataforma de gestión Agent 365.
El caso más citado de retorno concreto sigue siendo Klarna: según Forbes, la compañía proyectó una mejora de utilidad de US$40M para 2024 tras implementar su asistente de IA, que atendió 2,3 millones de conversaciones en su primer mes, una carga equivalente a la de 700 agentes a tiempo completo, y bajó el tiempo de resolución de 11 minutos a menos de 2.
El cuello de botella, sin embargo, no es el modelo. Un informe de MIT Technology Review patrocinado por Snowflake y citado en el anuncio de Snowflake Expedition 2026 encontró que el 55% de los ejecutivos señala la falta de contexto de negocio como la causa principal de insights pobres generados por agentes, y un 45% apunta a datos fragmentados o inaccesibles. La coordinación entre agentes es un problema de ingeniería; la calidad del contexto es un problema de datos, y suele ser el que decide si el sistema sirve.
La presión regulatoria y de confianza también avanza. American Express presentó su Intent Intelligence Framework para autenticar la intención de compra antes de que un agente cierre una transacción, y según TechCrunch, un 66% de los consumidores estadounidenses encuestados por Amex dice que probablemente use agentes de IA para investigar el mejor precio de un producto o servicio. En paralelo, una revisión publicada en Artificial Intelligence Review el 27 de octubre de 2026 organiza la investigación sobre agentes LLM en seis dimensiones de orquestación multi-herramienta, incluidas seguridad, control y eficiencia bajo restricciones de recursos.
Conclusión
La arquitectura multiagente te compra descomposición de tareas: la capacidad de partir un problema grande y difuso en piezas más chicas, cada una más fácil de promptear, testear y razonar. No te compra corrección. Un sistema de cinco agentes que alucinan un 5% de las veces cada uno no promedia a un comportamiento más confiable: lo compone.
El patrón que elijas define cómo se reparte el trabajo. El conjunto de pruebas y los guardrails que construyas alrededor definen si el sistema es seguro para poner delante de usuarios. Ahí es donde conviene gastar el tiempo de ingeniería.
Fuentes
- Building a Multi-Agent System from Scratch: Architecture Patterns (fuente original)
- Multi-Agent AI Systems: The Architectural Shift Reshaping Enterprise Computing (Forbes)
- Snowflake Helps Enterprises Deploy AI Agents with Trusted Business Context and Built-In Controls (TMCnet)
- Microsoft named a Leader in the 2026 Gartner Magic Quadrant for AI Agent Management Platforms
- Amex introduces a framework to prevent AI agents from making unauthorized purchases (TechCrunch)
- Survey maps how LLM agents moved from single tool calls to multi-tool orchestration
Leíste lo que hace la IA. ¿Y en tu negocio?
Un agente de IA puede quedarse con parte de tu día: ordenar lo pendiente y pedirte el OK antes de actuar. El Kit «tu mano derecha con IA» trae un video de 11 minutos y una ficha para dejar al tuyo trabajando. CAR está cerrada por ahora; al anotarte, te avisamos cuando abra.
👥 Quiero el Kit →