Qué anunció Google con Antigravity y /teamwork
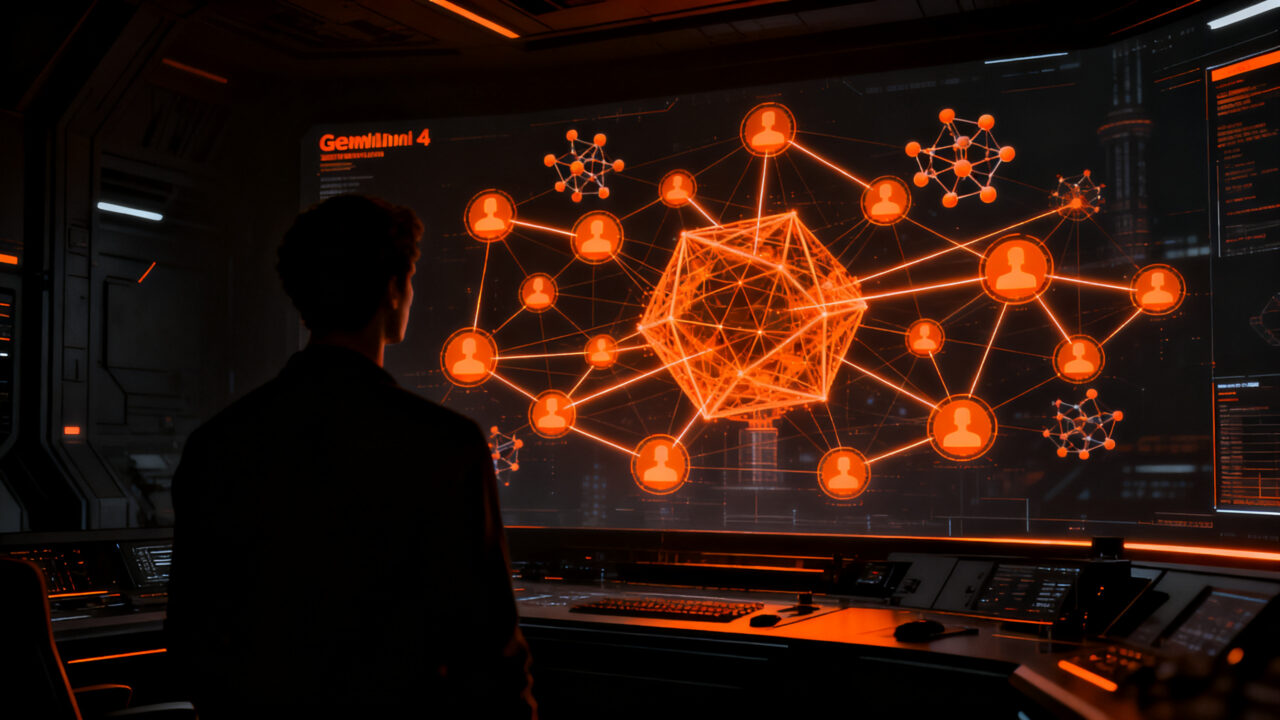
Google publicó el 13 de noviembre nuevos resultados de /teamwork, el sistema multiagente de su plataforma de desarrollo Antigravity. La propuesta es concreta: en vez de pedirle a un solo modelo una respuesta larga, el sistema reparte el trabajo entre agentes especializados y suma verificadores dedicados —el comprobador de pruebas Lean 4, suites de tests sin modificar, simuladores de ejecución, búsqueda web o contadores de hardware— que validan automáticamente qué candidato funciona.
El diseño ataca dos límites conocidos de los modelos de lenguaje. El primero es que la generación es impredecible: existe una brecha entre un intento y la respuesta correcta, y /teamwork la cierra combinando exploración en paralelo con falsadores. El segundo es que los modelos pierden el hilo en tareas de varios días, porque la atención se dispersa a medida que crece la ventana de contexto. La solución es particionar el contexto por construcción: cada agente recibe solo los archivos y herramientas de su paso, los coordinadores entregan el trabajo a sucesores nuevos, y críticos y auditores revisan desde contextos limpios, sin arrastrar el razonamiento del productor original.
Los modelos que corren debajo son Gemini 4 Argon, Gemini 4 Carbon y Gemini 4 Hydrogen, según detalla el propio anuncio.
¿Y esto cómo se aplica en tu negocio?
Dueños de negocio de Latinoamérica y España usan un agente de IA para ganar más y recuperar su tiempo. El Kit «tu mano derecha con IA» te muestra cómo en un video de 11 minutos, con una ficha para armar el tuyo. CAR está cerrada por ahora; al anotarte, te avisamos cuando abra.
👥 Quiero el Kit →Los resultados: de la conjetura de Courtade–Kumar al kernel de Zircon
Los números del anuncio son difíciles de ignorar. Investigadores de Google, CUHK, USC y CMU usaron el patrón Long Proof para demostrar en toda su generalidad la conjetura de Courtade–Kumar, un problema de teoría de la información planteado en 2013. La demostración se formalizó en Lean 4 y produjo 50 millones de líneas de código.
El caso más llamativo es LEAP, el framework multiagente desarrollado junto a Google Cloud AI. Con Argon, produjo de forma autónoma una formalización completa y verificada por máquina de las conjeturas de Weil, el resultado sobre conteo de soluciones de ecuaciones polinómicas sobre cuerpos finitos que Pierre Deligne demostró en 1974. Fueron alrededor de 1,8 millones de líneas de Lean generadas en 28.800 invocaciones de subagentes. El sistema también sintetizó más de 919.000 líneas para la primera formalización de una prueba reciente del décimo problema de Hilbert sobre anillos generales de enteros, y reprodujo la formalización de la explosión en tiempo finito de las ecuaciones de Navier–Stokes en 3D, ligadas a uno de los siete Problemas del Milenio y abiertas hace unos 90 años.
En ingeniería de software, el patrón de reescritura resolvió un problema clásico: las migraciones fallan cuando los agentes dejan dependencias en stub o modifican los tests para que pase un port roto. La solución fue agendar cada módulo solo después de que sus dependencias compilen, enlazando cada módulo hoja contra la suite de tests original sin modificar. Sobre el 25% inicial del microkernel Zircon, una campaña de dos semanas con Argon reescribió el C++ restante y agregó cerca de 800.000 líneas de Rust seguro que pasan los tests unitarios del kernel y arrancan en hardware arm64. En paralelo, libgav1, el decodificador de video AV1 de Google, pasó de C++ a unas 170.000 líneas de Rust con paridad bit a bit del 100%. Al principio el port era unas 4 veces más lento; tras darle acceso a herramientas de profiling, quedó 20% a 30% más rápido que el C++ original y el ensamblador optimizado a mano, tanto en x86_64 como en ARM.
También hay resultados en química e infraestructura. Un equipo de 30 agentes especializados con un simulador físico logró 95% de acierto top-1 y 100% top-3 al determinar estructuras moleculares a partir de datos de resonancia magnética nuclear, casi duplicando el desempeño de un solo agente. Y según Interesting Engineering, el flujo de scheduling agéntico de Google redujo la preempción de cargas de trabajo en TPU un 24% en algunos tipos de hardware, manteniendo los objetivos de nivel de servicio.
¿Cuánto cuesta y quién puede usarlo hoy?
/teamwork y /boost ya están disponibles en Antigravity, junto con Deep Review. Google abrió además postulaciones para que 10.000 investigadores académicos accedan gratis durante seis meses a su tier de mayor uso.
En precios, The Verge reportó que Gemini 4 Carbon salió con un precio introductorio de US$2 por millón de tokens de entrada y US$10 por millón de salida, alrededor de un quinto del costo del GPT-6 Astra de OpenAI, y que esos valores se duplican a fin de mes. WinBuzzer detalló que Gemini 4 Hydrogen se ofrece a US$1,50 por millón de entrada y US$7,50 por millón de salida, y que su modo Orchestrator —Carbon planifica, Hydrogen implementa— consumió en promedio 24% menos cuota y terminó 19% más rápido que usar solo el modelo de planificación. Según blockchain.news, Hydrogen se lanzó el 12 de noviembre con una ventana de contexto de hasta 1 millón de tokens.
Qué significa esto para tu startup
El valor de este anuncio no está en los teoremas: está en los patrones de orquestación, que son replicables con cualquier stack. Tres cosas que puedes implementar esta semana.
-
Separa el generador del verificador. El hallazgo más transferible es que un agente que revisa desde un contexto limpio detecta errores que el productor no ve. Si hoy usas un solo modelo para generar y revisar código, contratos o análisis financieros, divide el flujo: un agente produce, otro audita sin acceso al razonamiento del primero y con una herramienta objetiva de validación (tests, un linter, una consulta a la base de datos). Es la diferencia entre «el modelo dice que está bien» y «el sistema lo comprobó».
-
Construye evaluadores proxy antes de escalar. El patrón DuoDiscover resuelve un cuello de botella que cualquier equipo de ML reconoce: las evaluaciones completas de kernels en TPU tardan entre 7 y 32 minutos, lo que limita cuántos candidatos se pueden explorar. Cuatro agentes en paralelo construyeron evaluadores proxy de 23 segundos, validados periódicamente contra corridas completas en hardware real usando la correlación de rangos de Kendall. El resultado fue un speedup geométrico de 4,09x en 17 kernels de JAXBench y de 2,99x en 7 kernels de vLLM. Si tu benchmark tarda horas, ese cuello de botella es tu techo de iteración.
-
No dejes que el agente toque los tests. Si estás planificando una migración de lenguaje o de framework, adopta la regla del patrón de reescritura: la suite de tests original queda intacta y cada módulo se agenda solo cuando sus dependencias compilan. Es lo que separa un port que funciona de uno que pasa los tests porque alguien los aflojó.
-
Mide el costo por tarea, no por token. El precio por millón de tokens es solo la mitad de la ecuación: modelos distintos consumen cantidades distintas de tokens para la misma tarea. WinBuzzer señala que Antigravity mide la cuota incluida por trabajo realizado, así que la reducción de cuota del 24% no se traduce en un ahorro fijo en dólares para tu proyecto. Corre tu propio benchmark con tus prompts reales antes de decidir.
Los límites que conviene tener presentes
The Verge advirtió que las empresas eligen los benchmarks que las muestran mejor, y eso aplica acá: los speedups de 185x en memoria HBM o de 2.300x en self-play corresponden a cargas muy específicas, no a tu caso de uso. El propio anuncio aclara que el trabajo se hizo en colaboración con expertos humanos que enmarcan las preguntas y definen las restricciones teóricas o físicas, y que en matemática formal un humano debe confirmar que el enunciado formal coincide con el problema original antes de que la prueba cuente.
Dicho de otro modo: el sistema acelera la exploración y la verificación, no reemplaza el criterio de quién decide qué problema vale la pena resolver. Ese sigue siendo el trabajo del founder y del investigador.
Conclusión
Antigravity y /teamwork muestran hacia dónde va la ingeniería asistida por IA: menos «un prompt, una respuesta» y más equipos de agentes con roles separados, verificadores objetivos y contexto particionado. Para una startup hispanohablante con equipo chico, la lección práctica es que la arquitectura importa más que el modelo. Un flujo con un generador, un verificador independiente y un evaluador rápido bien calibrado rinde más que cambiar de modelo cada mes. Y con 10.000 accesos gratuitos para investigadores académicos sobre la mesa, hay una ventana concreta para que equipos de investigación en LATAM y España prueben estas herramientas sin costo durante seis meses.
Fuentes
- Google Research: Advancing science and engineering with Antigravity’s /teamwork (fuente original)
- Interesting Engineering: Google Antigravity agents tackle 90-year-old math problem and rewrite software
- The Verge: Google releases Gemini 4 Carbon with agent ‘swarm’ feature
- WinBuzzer: Google Antigravity Pairs Gemini 4 Models With New Orchestrator
- blockchain.news: Google Launches Gemini 4 Hydrogen for Efficient Coding and Debugging
¿Y esto cómo se aplica en tu negocio?
Dueños de negocio de Latinoamérica y España usan un agente de IA para ganar más y recuperar su tiempo. El Kit «tu mano derecha con IA» te muestra cómo en un video de 11 minutos, con una ficha para armar el tuyo. CAR está cerrada por ahora; al anotarte, te avisamos cuando abra.
👥 Quiero el Kit →