La startup que apuesta a mover datos con luz, no con cobre
La estadounidense Volantis cerró el 1 de octubre de 2026 una Serie A de US$88 millones para atacar un problema que cada año pesa más en la factura de la inteligencia artificial: el "memory wall", la pared invisible entre la potencia bruta de las GPU y la velocidad con la que esas GPU pueden leer y escribir datos en la memoria.
Su propuesta suena a ciencia ficción, pero se apoya en un componente que ya llevas en el bolsillo: láseres diminutos del tipo VCSEL, los mismos que Apple usa en el Face ID del iPhone. La diferencia es que Volantis los reorienta al interior de los servidores, donde el cobre empieza a no dar más.
Qué es Volantis y quién está detrás
Volantis es una startup de semiconductores con sede en San Francisco, fundada en 2022 por Tapa Ghosh (CEO, ex Thiel Fellow y ex fundador en Y Combinator) y Roy Meade (CTO, ex líder del programa HBM en Micron y ex VP en Ayar Labs), según reportó Unite.ai.
🤖 La IA no es solo para leer sobre ella
En la comunidad la aplicamos: automatización, agentes IA y herramientas reales para emprender, no solo para informarte.
👥 Aplicarla en la comunidadLa ronda de US$88M fue co-liderada por Lachy Groom y Abstract Ventures, con la participación de John Doerr (chairman de Kleiner Perkins), VXI Capital, Triatomic y Susa Ventures, más una camada de ángeles de peso: Dwarkesh Patel, Naveen Rao y Sholto Douglas, según el reporte de Reuters recogido por Hoodline. En su ronda semilla de US$9M en 2025 ya habían entrado Sam Altman, Jeff Dean, Dylan Patel (SemiAnalysis), Naval Ravikant, Thomas Wolf (Hugging Face) y Trevor Blackwell. Con la Serie A, Volantis acumula US$97M totales, según Unite.ai.
El equipo arrastra experiencia directa desde NVIDIA, AMD, Broadcom y Ayar Labs, con créditos que incluyen el primer producto CoWoS de la industria, los primeros VCSEL sintonizables de alto volumen y sistemas pioneros de óptica co-empacada en silicio.
Por qué importa: el "memory wall" que frena a la inferencia
Cada vez que un modelo grande responde a un prompt, su fase de decode (generar el siguiente token, uno a uno) no está limitada por la aritmética de la GPU, sino por qué tan rápido la memoria le entrega los pesos del modelo. Ahí entra la HBM ("high-bandwidth memory"), un tipo de DRAM apilado en 3D que solo fabrican SK Hynix, Samsung y Micron, y que requiere el empaquetado avanzado CoWoS de TSMC para integrarse a la GPU.
Ese cuello de botella se ha vuelto tan estructural que la HBM ha estado sold out durante todo 2026, y la Serie A de Volantis llega justo cuando el mercado busca alternativas. La arquitectura de Volantis busca sacar parte de ese tráfico del cobre y pasarlo a luz, usando micro-VCSEL (láseres de emisión vertical de cavidad superficial) que disparan haces de luz directamente sobre la superficie del chip, según reportó Crypto Briefing.
Cómo funciona la arquitectura fotónica de Volantis
En los sistemas actuales, una GPU se conecta a unos 8 chips de HBM mediante pistas eléctricas que miden entre 2 y 5 milímetros, según datos de la propia página de tecnología de Volantis citados por Unite.ai. A medida que los modelos piden más contexto y más parámetros, esa distancia corta se convierte en cuello de botella.
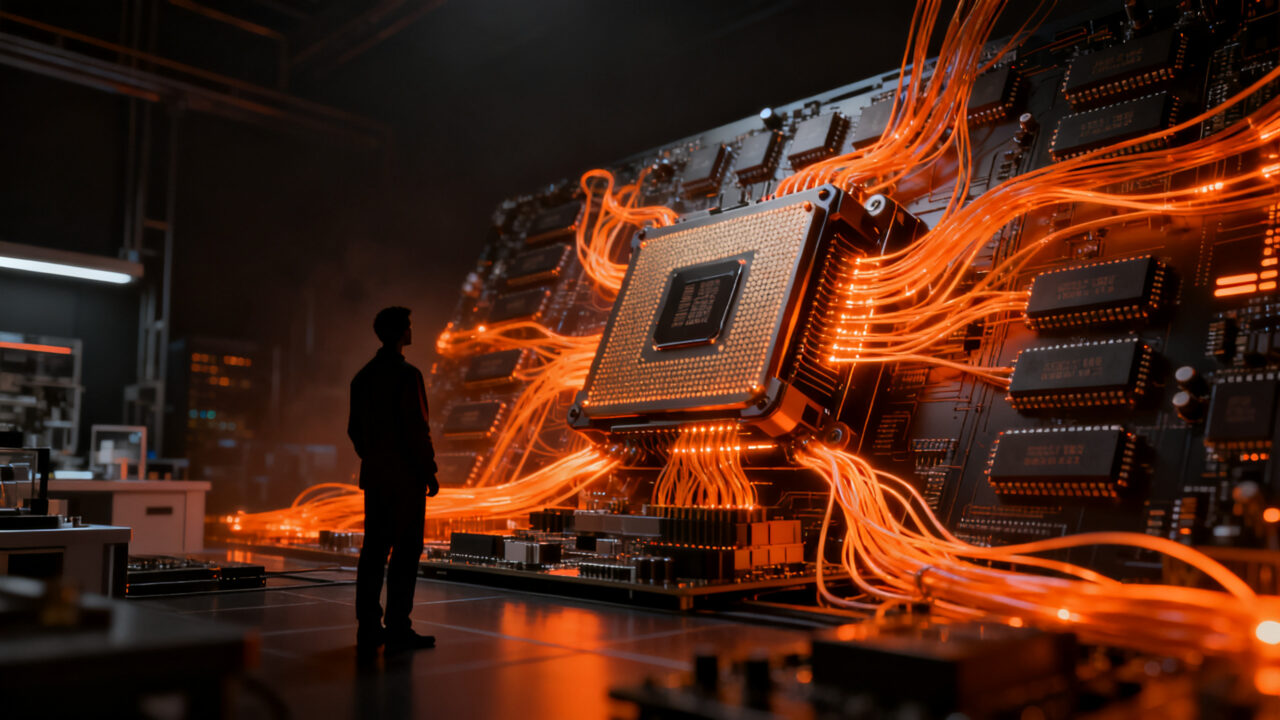
Volantis reemplaza parte de ese cableado eléctrico por guías de onda ópticas que superan los 200 milímetros y enlazan más de 220 chiplets de memoria en un único pool de memoria con latencia uniforme. El componente clave es un micro-VCSEL personalizado que se integra en el propio chip, lo que evita láseres externos y consume menos de 1 picojulio por bit, según Unite.ai.
Las especificaciones técnicas que la compañía publica en su web:
- 24 Gbps por carril, con latencia sub-5 nanosegundos
- Escalado a decenas de miles de carriles, más de 200 TB/s de ancho de banda agregado
- 220+ chiplets de memoria en un mismo pool
- Operación estable por encima de 95°C, con tasa de error por debajo de 1e-12 a nivel de oblea
- 25 patentes registradas para proteger la arquitectura, según Embedded.com recogido por Hoodline
La compañía presume que su motherboard fotónica está diseñada para agrupar más de 100 TB de memoria por chip, con ancho de banda por encima de 30 TB/s.
El sistema A-1: qué promete y cuándo llega
El primer producto concreto de Volantis se llama A-1, un motor de inferencia integrado en formato rack. Los números que la startup publica en su ficha de producto, citados por Unite.ai:
- Modelos de más de 20 billones de parámetros
- Hasta 10.000 tokens por segundo por usuario
- 10 TB de capacidad de memoria
- 240 TB/s de ancho de banda de memoria
- 10 TB/s de IO off-wafer
- Envolvente de potencia de 20 kW en formato 15U (compatible con racks de datacenter actuales)
La compañía afirma que A-1 entregaría 15 veces más tokens por dólar que la NVIDIA Rubin, 6 veces más tokens por vatio en modelos mixture-of-experts por encima de un billón de parámetros, y más de 30 veces menos latencia para inferencia de modelos grandes. Muestras en el cuarto trimestre de 2026 y primeros motores integrados a clientes durante 2027, según Embedded.com y Unite.ai.
Ghosh lo resumió ante Reuters con una frase que vale la pena recordar: "A nadie le van a dar un Nobel si este proyecto funciona, pero la buena noticia es que no lo van a necesitar".
Una categoría caliente: no están solos
Volantis no corre en vacío. La categoría de fotónica para IA está entre las más activas del venture capital en 2026:
- Ayar Labs (San José) amplió su fondeo 2026 a US$650M y trabaja con NVIDIA, AMD, Intel y MediaTek como backers estratégicos, según Semiconductor Today.
- Lightmatter lidera el grupo Open Silicon Photonics for AI Systems dentro del Open Compute Project y espera enviar partes de óptica co-empacada fabricadas en TSMC y GlobalFoundries en 2028, según SDxCentral.
- Olix (Londres) cerró una Serie B de US$312M a valuación de US$3.300M con una arquitectura que también esquiva la HBM, reportó TechTimes.
- Neurophos (Austin) levantó US$110M en enero de 2026 para su Optical Processing Unit, según CNBC recogido por TechTimes.
El contexto macro ayuda: según datos de PitchBook citados por TechTimes, en 2026 se han comprometido US$16.000M en inversión semiconductor a nivel global, 30% por encima del récord del año anterior, y Dealroom estima que las startups de chips de IA captaron US$8.300M solo en lo que va de año. SemiAnalysis pronostica que todos los interconectores de alto ancho de banda en data centers podrían volverse ópticos en los próximos cinco años.
Qué significa esto para tu startup
Aunque la Serie A de Volantis ocurre a nivel de infraestructura de hardware,信号 para founders que construyen sobre IA es directo: el costo de la inferencia todavía tiene margen grande para caer, y la próxima bajada no vendrá de modelos más pequeños, sino de hardware especializado en mover datos.
Acciones concretas que podés tomar esta semana:
- Audita tu gasto en inferencia por usuario activo. Si dependes de modelos grandes en producción, mapea tokens/segundo, latencia p95 y costo por token. Los anuncios de Volantis, Ayar Labs y Olix apuntan a caídas de un orden de magnitud en 24-36 meses; lo que firmes hoy en contratos de GPU debería poder renegociarse o sustituirse.
- Diseña tu producto para asumir contexto más largo sin re-arquitecturarlo. Si el memory wall se rompe, los productos que ya sepan manejar ventanas de contexto grandes, retrieval largo y memoria persistente en sesión van a capturar el salto. Si tu arquitectura actual asume ventanas cortas, planeá el upgrade ahora.
- No te cases con un solo proveedor de cómputo. La conversación "NVIDIA vs AMD vs startup fotónica" va a abrirse. Mantené tu stack portable (vLLM, Triton, ONNX, weights agnósticos) para poder mover carga cuando aparezcan ofertas de inferencia con 10x mejor precio/rendimiento.
Una pregunta incómoda para founders de capa de aplicación: si el costo de inferencia cae 10x en dos años, ¿qué parte de tu moat basado en "tenemos el modelo afinado más eficiente" desaparece, y cuál se refuerza?
Fuentes
- Una startup recauda US$88 millones para atacar uno de los grandes límites de los chips de inteligencia artificial (fuente original)
- Volantis Raises $88M Series A to Build Photonic AI Inference System — Unite.ai
- San Francisco Startup Volantis Lands $88M to Zap AI's Memory Bottleneck With Light — Hoodline
- Volantis raises $88M Series A to attack the AI memory bottleneck with light — Crypto Briefing
- Ayar Labs expands 2026 funding to $650m to scale manufacturing-ready CPO — Semiconductor Today
- Olix Raises $312M for Photonic AI Chip That Ditches HBM — TechTimes
🤖 La IA no es solo para leer sobre ella
En la comunidad la aplicamos: automatización, agentes IA y herramientas reales para emprender, no solo para informarte.
👥 Aplicarla en la comunidadArtículos relacionados:
 Memoria en IA: guía 2026 para founders (ChatGPT, Claude, Gemini)
 Memoria persistente para agentes IA: 4 tipos que necesita tu startup en 2026
 Agent Memory: 4 componentes para IA que recuerda
 Claude con memoria: qué cambia para emprendedores
 Universal Memory Protocol: libera agentes IA del vendor lock-in