Un solo prompt, seis horas y dos modelos de frontera: la prueba de fuego del diseño agéntico
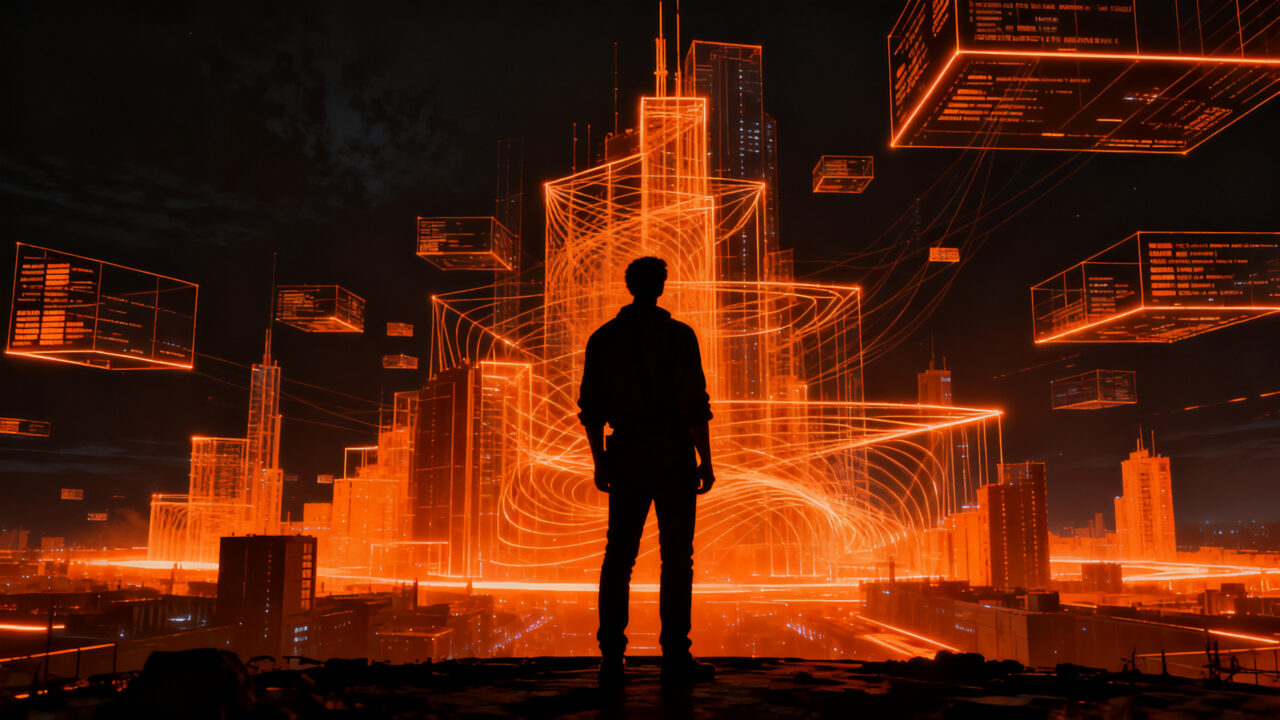
El ingeniero y data storyteller Przemysław Jamróz, de Quesma, publicó un experimento que recorrió el ecosistema de IA esta semana: darle a un modelo de frontera un único prompt, sin preguntas, y dejarlo trabajar seis horas en una visualización interactiva de Las ciudades invisibles de Italo Calvino usando three.js. El objetivo no era solo ver qué generaba, sino cuánto tardaba y cómo de “terminado” llegaba el resultado sin intervención humana.
La conclusión que dejó en su blog —“I gave Opus 5.5 one prompt and six hours to visualize Invisible Cities”— es directa: Claude Opus 5.5 entrega, en una sola pasada, una calidad de visualización que antes requería iteración humana. Y lo hace gastando apenas una fracción del tiempo presupuestado.
Qué pasó exactamente: un prompt, dos modelos, dos resultados muy distintos
Jamróz diseñó la prueba para evitar el “AI design slop”: resultados bonitos por fuera, vacíos por dentro. El prompt fue explícito y limitante: “Make a three.js (pnpm) visualization of all Invisible Cities by Italo Calvino. Don’t ask questions, it is a one-shot task. You have 6h of work, use it until it becomes a masterpiece.”
¿Y esto cómo se aplica en tu negocio?
En CAR, dueños de empresa de Latinoamérica y España usan la tecnología para ser más rentables. Empiezas con una ruta de 7 días y terminas con un sistema funcionando en tu negocio.
👥 Probar 7 díasPrimero lo lanzó contra GPT-6 Astra, el modelo de razonamiento presentado por OpenAI el 3 de septiembre. El resultado fue funcional, pero con problemas típicos del diseño generativo: conceptos redundantes, comentarios obvios que no aportan, y un estilo visual que Jamróz describe como “prestado” — fondo beige, tipografías con números como “05”, la huella estética de Claude. “No habría esperado que modelos anteriores llegaran ni de lejos a esto”, escribió.
Luego probó el mismo prompt con Claude Opus 5.5, lanzado por Anthropic el 22 de septiembre. El modelo declaró haber usado la mitad de las seis horas, aunque en realidad solo empleó 1 hora y 25 minutos de reloj, sumando cerca de 7 horas-agente al paralelizar seis subagentes. “Quería regañar a Opus 5.5 por terminar antes, hasta que vi el resultado”, escribió Jamróz. El cierre del post es casi confesional: “I’m in awe, but I’m also asking myself: what is my place in creating interactive media?”
Por qué importa este experimento: del código al producto, en una sola toma
El caso de Jamróz no es un benchmark sintético como Terminal-Bench o GPQA Diamond, donde los modelos rinden contra tests cerrados. Es una tarea de diseño abierta, con criterios estéticos y técnicos propios — exactamente el tipo de trabajo que hoy contratan estudios de visualización, agencias de product design y equipos de growth.
Anthropic presentó Opus 5.5 el 22 de septiembre como el primer modelo de la familia Claude 5.5, con un coste de inferencia 40% inferior al de Opus 5 en cargas típicas, generación de salida más de un 30% más rápida y mejoras explícitas en agentic coding, computer use y knowledge work, según la propia compañía. OpenAI respondió el mismo día con GPT-6 Sol y GPT-6 Luna, versiones orientadas a workloads de alto volumen con precios más bajos.
En cifras concretas de mercado y rendimiento reportadas por los medios:
- Anthropic lista Opus 5.5 a US$4 por millón de tokens de entrada y US$20 por millón de salida, con cache reads a US$0,20 por millón (60% más barato). (IJR)
- Opus 5.5 alcanzó 66,4% en Terminal-Bench 4.0, frente a 55,8% de Fable 5.1 y 57,9% de GPT-6 Astra. (IJR)
- OpenAI lista GPT-6 Astra a US$10 por millón de tokens de entrada y US$50 por millón de salida. (Mashable)
- GPT-6 Astra marcó 97,6% en FrontierMath Tier 4 (v2), 96,0% en GPQA Diamond, 64,6% en Terminal-Bench Science 0.1 y 100% en ExploitBench, según la tarjeta del sistema publicada por OpenAI. (Mashable)
- En FrontierCode, Opus 5.5 llegó a 54,4% frente a 50,3% de Fable 5.1. (IJR)
La diferencia con la prueba de Jamróz es importante: él no mide cuántos problemas de código resuelve el agente, sino qué tan pulido llega el output sin un humano corrigiendo. Y ahí, Opus 5.5 le dio “wow” en 85 minutos reales.
La tensión invisible: el diseñador en la era del “one-shot”
El post termina con una pregunta incómoda para cualquier founder o creativo técnico: “¿cuál es mi lugar en la creación de medios interactivos?” No es una pregunta retórica. Si un modelo entrega, en menos de dos horas, una visualización que un estudio humano tardaría días en producir, el rol del diseñador cambia de “ejecutor” a “director de calidad y criterio”.
Hay dos señales a observar:
- El coste de la experimentación cae en picado. Si antes necesitabas un equipo para prototipar una landing interactiva o un explorable explanation, ahora puedes pedirle al modelo una decena de variantes y quedarte con la mejor. Anthropic redujo 40% el coste de inferencia entre Opus 5 y Opus 5.5; OpenAI lanzó GPT-6.1 Sol el 29 de septiembre prometiendo rendimiento similar a Astra a aproximadamente la mitad de precio, según SiliconANGLE.
- El techo de calidad subjetiva sube más rápido que el techo de los benchmarks. Los benchmarks (FrontierMath, Terminal-Bench, GPQA) miden razonamiento y código; el “wow” de Jamróz mide gusto, coherencia visual y cumplimiento de intención, dimensiones que ningún leaderboard captura todavía.
Para los founders hispanohablantes, esto tiene una lectura práctica inmediata: la barrera de entrada para producir contenido interactivo de calidad —visualizaciones, microsites, demos para investors— se desplomó en el último trimestre.
¿Qué significa esto para tu startup?
Más allá del titular, el experimento de Jamróz deja tres movimientos accionables para quien construye producto hoy:
- Incorpora “one-shot prompts con tiempo presupuestado” a tu flujo de prototipado. En lugar de pedirle a un modelo “hazme una landing”, dale contexto, librería objetivo (three.js, p5.js, D3), y un techo de tiempo o tokens. Opus 5.5 respondió mejor cuando se le dio estructura, no cuando se le dio ambigüedad. Acción concreta: arma un prompt plantilla con 4 bloques (objetivo, stack, restricciones, tiempo) y compáralo contra tu flujo actual en 3 proyectos pequeños.
- Mide output, no solo output-token. Los benchmarks que importan en diseño son cualitativos: coherencia visual, accesibilidad, cumplimiento de intención. Crea una rúbrica interna de 5 criterios (estilo, usabilidad, accesibilidad, fidelidad a la marca, código limpio) y úsala para evaluar qué modelo gana en cada tipo de tarea. Acción concreta: la próxima vez que tu equipo use un agente para diseño, evalúa con la rúbrica antes de aceptar el resultado; vas a descubrir cuándo el modelo “termina pronto” porque el techo era bajo, no porque fue eficiente.
- Reposiciona al diseñador como curator. Si un agente entrega 80% del trabajo en 85 minutos, el valor humano se concentra en el 20% restante: criterio, coherencia con marca, decisiones que requieren contexto de negocio. Acción concreta: reescribe la descripción de puesto de tu equipo de diseño/producto para que el entregable principal sea “decisiones”, no “artefactos”.
La pregunta de Jamróz —“what is my place in creating interactive media?”— no tiene respuesta única. Pero la dirección es clara: el modelo ya es el ejecutor; el founder decide qué se ejecuta y por qué.
Fuentes
- I gave Opus 5.5 one prompt and six hours to visualize Invisible Cities — Quesma
- Anthropic Launches Claude Opus 5.5 With 40% Lower Costs And Over 30% Faster Output — Pulse 2.0
- Anthropic launches Claude Opus 5.5 with stricter safeguards for cybersecurity — The Verge
- Anthropic Releases Claude Opus 5.5 With Stronger Safety Tests and Lower Price — IJR
- OpenAI's GPT-6 Astra scores 97.6% on FrontierMath after internal version started at just 17% — CryptoBriefing
- OpenAI officially launches GPT-6 Astra, a boundary-breaking new model — Mashable
- OpenAI's GPT-6.1 Sol delivers Astra-like performance at a dramatically lower price — SiliconANGLE
¿Y esto cómo se aplica en tu negocio?
En CAR, dueños de empresa de Latinoamérica y España usan la tecnología para ser más rentables. Empiezas con una ruta de 7 días y terminas con un sistema funcionando en tu negocio.
👥 Probar 7 díasArtículos relacionados:
 GPT-6 Astra en OpenRouter: precios, benchmarks y qué cambia
 Anthropic lanza Claude Opus 5.5: más seguro y 40% más barato
 GPT-6 Astra: OpenAI lanza su modelo más potente y supera a Fable 5.1
 GPT-6 Astra, Fable 5.1, Grok Bot y Muse: dos semanas que cambiaron todo
 GPT-6.1 Sol: rendimiento casi de Astra a un quinto del coste