Qué es Auto Ontology y por qué NVIDIA lo abre
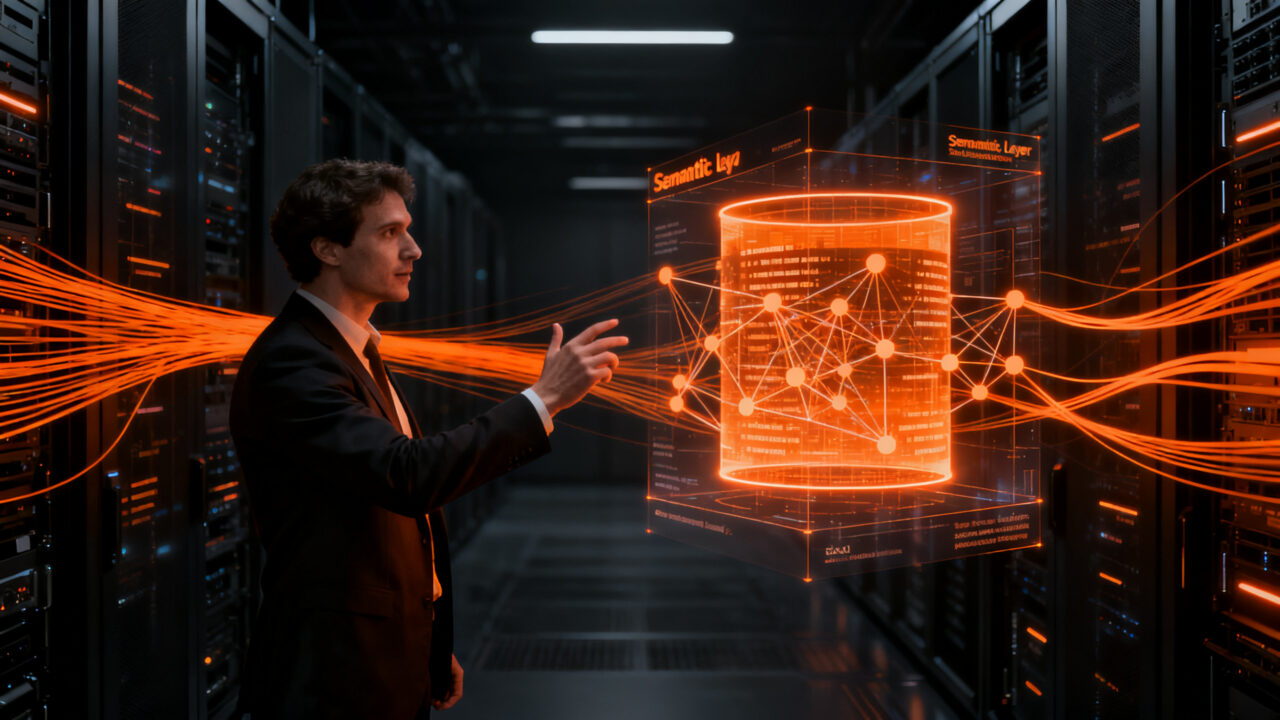
NVIDIA publicó Auto Ontology, una biblioteca de código abierto bajo licencia Apache 2.0 que inserta una capa de contexto empresarial entre los agentes de IA y las bases de datos. El problema que ataca es concreto: un agente puede escribir SQL sintácticamente perfecto y devolver un número equivocado, porque nadie le dijo qué significa "ingresos" en esa empresa.
La propuesta no es un modelo nuevo ni un agente nuevo. Es infraestructura: una capa semántica que organiza metadatos, términos de negocio, relaciones y procedencia de los datos para que el agente consulte ese contexto antes de generar la consulta. NVIDIA describe el resultado como una ontología inicial, no como una fuente de verdad lista para producción.
Ese matiz importa. Según la página para desarrolladores de la compañía, los expertos de negocio deben probar, refinar y certificar la ontología generada. Una columna llamada "ventas" puede representar ingresos brutos, transacciones cerradas o una cifra calculada con reglas internas; la capa semántica orienta, pero alguien con conocimiento del negocio tiene que confirmar que la interpretación sea la correcta.
¿Y esto cómo se aplica en tu negocio?
Dueños de negocio de Latinoamérica y España usan un agente de IA para ganar más y recuperar su tiempo. El Kit «tu mano derecha con IA» te muestra cómo en un video de 11 minutos, con una ficha para armar el tuyo. CAR está cerrada por ahora; al anotarte, te avisamos cuando abra.
👥 Quiero el Kit →Cómo funciona: cinco funciones, nueve herramientas MCP y Nemotron por defecto
Auto Ontology se organiza en cinco funciones: descubrir ontologías desde metadatos y conectar modelos semánticos existentes; fundamentar métricas, entidades y relaciones; validar consultas contra definiciones certificadas y su linaje; exponer el contexto vía MCP, CLI y API; e incorporar correcciones certificadas de vuelta a la ontología.
La arquitectura combina cuatro servicios: interfaz web en Next.js 16 (puerto 3000), backend FastAPI con LangChain (3001), worker de ingesta de embeddings (3002) y PostgreSQL con pgvector para catálogo, ontología y vectores. Las fuentes de datos soportadas son Databricks, PostgreSQL, Snowflake y DuckDB.
El modelo por defecto es nvidia/nemotron-3-nano-30b-a3b, acompañado de modelos Nemotron para embeddings y reranking. La inferencia puede correr en endpoints alojados de NVIDIA NIM, en instancias autoalojadas o en cualquier endpoint compatible con OpenAI.
Para conectar agentes, el servidor MCP expone nueve herramientas de solo lectura. ask_question devuelve por separado la respuesta, el SQL y las filas, con un tope de 100 resultados; check_readiness verifica que existan una capa semántica compilada y una conexión activa a la base de datos. Un detalle relevante: no hay herramienta para explorar esquemas crudos. Es una decisión deliberada para forzar que el agente pase siempre por la capa semántica. La especificación OpenAPI publica 87 operaciones y el inicio de sesión usa OAuth, con permisos heredados del usuario autenticado.
La letra chica: 90% más rápido, pero sin cifras de precisión
NVIDIA reporta que sus pruebas redujeron 90% el tiempo necesario para crear ontologías. Es una afirmación de la propia compañía y mide velocidad de preparación de la capa, no la tasa de aciertos de los agentes al responder preguntas de negocio.
El repositorio de evaluación, auto-ontology-eval, trae el conjunto de pruebas pero no resultados publicados. Compara dos brazos en NeMo Gym —un modelo de lenguaje con acceso al esquema contra un agente fundamentado en la ontología— usando coincidencia determinista de ejecución en lugar de un juez basado en otro modelo. Incluye BIRD Dev (1.534 preguntas, 11 bases de datos), Mini-Dev (500 preguntas), FDABench-Lite (169) y BEAVER (muestra de 100 por defecto).
Hay dos límites metodológicos que conviene tener presentes. Los ejemplos opcionales de few-shot y los anclajes de valor se entregan únicamente al brazo con ontología, así que cualquier diferencia futura incluiría el efecto de esas ayudas y no mediría el grounding semántico puro. Y la configuración probada encamina ambos brazos a través de un modelo Claude en la pasarela de inferencia de NVIDIA.
Traducción práctica: si quieres saber si Auto Ontology acierta en tu caso, tendrás que ejecutar el conjunto de pruebas en tu propio entorno.
Qué dicen los benchmarks del sector sobre las capas semánticas
Aquí el contexto externo ayuda a calibrar expectativas. El benchmark Spider 2.0 (ICLR, 2025) mostró que un agente con o1-preview resolvía 91,2% de las preguntas en Spider 1.0 —esquemas limpios y pequeños— pero solo 21,3% en esquemas empresariales reales, según recoge el análisis de Atlan sobre text-to-SQL empresarial. La caída no es de sintaxis: es de significado.
Un benchmark de dbt Labs de 2026, citado por Atlan, midió el efecto contrario: al enrutar las consultas por una capa semántica, la precisión de Claude Sonnet 4.6 pasó de 90,0% a 98,2% y la de GPT-5.3-Codex de 84,1% a 100%. Es un test del propio producto de dbt Labs, así que conviene leerlo con esa cautela, pero la dirección del hallazgo coincide con otras mediciones del sector.
El dato que más debería preocupar a un founder viene de una encuesta de Modern Data Company de 2026 sobre más de 540 líderes de datos en 64 países, recogida por Ampers: 57,3% ya pilotea o corre agentes de IA en flujos de datos y analítica, pero solo 8,4% considera sus datos lo bastante confiables para producción. La adopción se adelantó a la preparación. Y Gartner, en su Data & Analytics Summit de 2026, proyectó que 60% de los proyectos de analítica agéntica que dependan solo de acceso a datos a nivel de protocolo fracasarán hacia 2028.
Auto Ontology frente a otras capas semánticas
La comparación publicada por MarkTechPost ubica a Wren AI con archivos de contexto asistidos por agentes y más de 22 fuentes de datos, mientras Cube Core y dbt MetricFlow se apoyan en definiciones escritas en código. Auto Ontology se distingue por generar la ontología inicial desde metadatos y luego certificarla con especialistas.
Esa comparación no establece que una herramienta supere a las demás: no existe una evaluación común de rendimiento entre las cuatro. Lo que sí aporta es una diferencia de enfoque. Las capas definidas en código exigen que alguien modele cada métrica antes de que el agente la use; Auto Ontology arranca generando y deja la certificación como paso humano posterior. Menos trabajo inicial, más dependencia de que ese paso de certificación realmente ocurra.
¿Qué significa esto para tu startup?
Si estás construyendo producto sobre datos de clientes, la noticia no es "hay una herramienta nueva". Es que la industria está aceptando que el cuello de botella de los agentes de datos no es el modelo, sino la definición del negocio.
Dos acciones concretas:
Antes de conectar un agente a tu warehouse, escribe las definiciones. Elige tus 10 métricas más consultadas —MRR, churn, clientes activos, margen— y define una sola versión oficial de cada una, con su fuente y su dueño. El caso que InfoWorld recoge de la consultora Kanerika es ilustrativo: modelaron más de 40 entidades y estandarizaron más de 85 KPIs antes de poner agentes en producción, y el tiempo de investigación y reconciliación cayó cerca de 70%. No necesitas una ontología completa; necesitas que "cliente activo" signifique lo mismo para todos.
Prueba Auto Ontology en un entorno acotado, no en producción. Levanta el stack con Docker Compose sobre una réplica de lectura, apunta a una base DuckDB o PostgreSQL con datos no sensibles y ejecuta el conjunto de evaluación con tus propias preguntas. Como el proyecto no publica cifras de precisión text-to-SQL, la única evidencia que vale para tu caso es la que generes tú. Y revisa la configuración: si usas few-shot o anclajes de valor, estarás midiendo más que el grounding semántico.
Un tercer punto de higiene: el diseño de Auto Ontology no expone esquemas crudos al agente, y esa es una buena práctica que puedes copiar aunque no adoptes la herramienta. Cada llamada hereda los permisos del usuario autenticado vía OAuth, así que un agente nunca ve más de lo que ve quien pregunta.
Conclusión
Auto Ontology es una pieza de infraestructura, no un producto terminado. La licencia Apache 2.0 y la integración con MCP, CLI y API la hacen fácil de inspeccionar y adaptar; el despliegue está resuelto con Docker Compose, un gráfico Helm en Kubernetes —versión 1.1.0, con actualización registrada el 13 de octubre de 2026— y un contenedor NGC.
Lo que falta es la parte que más importa para decidir: evidencia pública de precisión. NVIDIA promete velocidad de preparación y entrega un conjunto de evaluación; la exactitud de las respuestas queda como tarea del usuario. Para un equipo con poco margen, eso significa que la decisión sensata no es adoptar ni descartar, sino medir. Y medir, en este caso, empieza por tener claras tus propias definiciones de negocio.
Fuentes
- DiarioBitcoin (fuente original)
- MarkTechPost
- Atlan
- Ampers
- InfoWorld
¿Y esto cómo se aplica en tu negocio?
Dueños de negocio de Latinoamérica y España usan un agente de IA para ganar más y recuperar su tiempo. El Kit «tu mano derecha con IA» te muestra cómo en un video de 11 minutos, con una ficha para armar el tuyo. CAR está cerrada por ahora; al anotarte, te avisamos cuando abra.
👥 Quiero el Kit →