Qualcomm Cloud AI 100 Ultra: 150W para sostener 128 GB de memoria
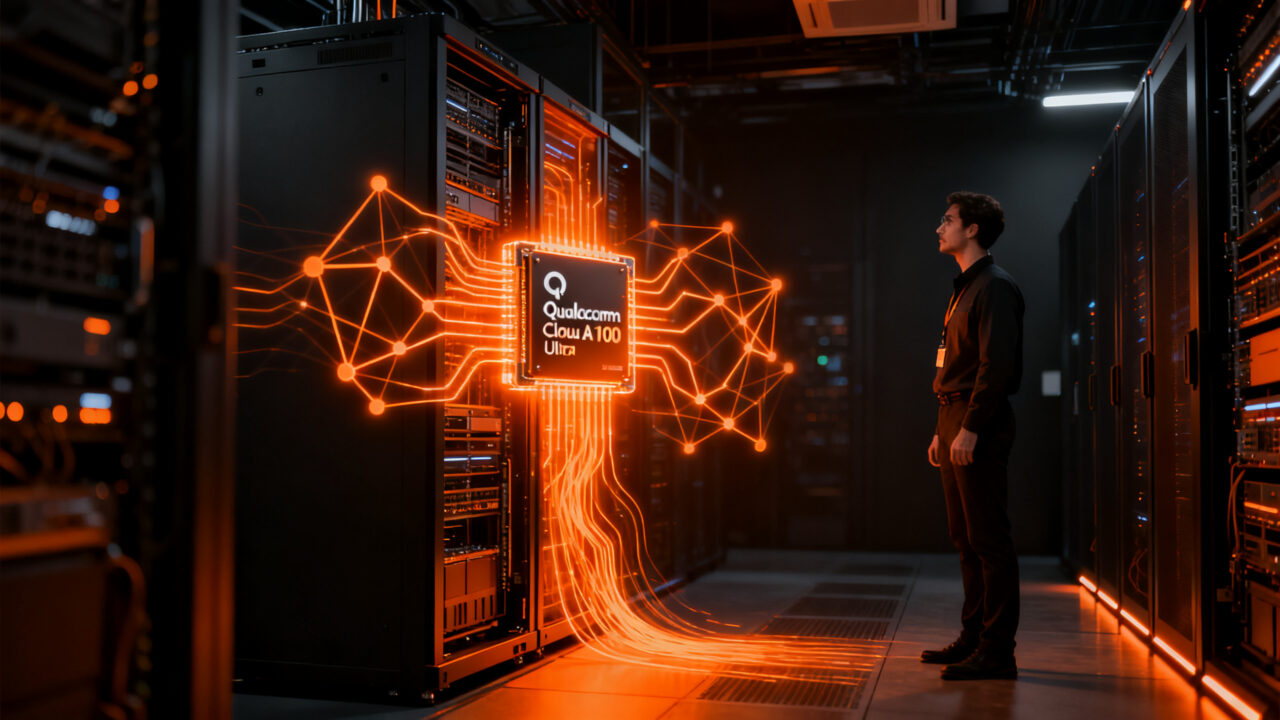
150 vatios de consumo y 128 GB de memoria LPDDR4x a 548 GB/s. Esa es la relación que Qualcomm documenta para la Cloud AI 100 Ultra, su tarjeta de inferencia de IA para data centers, con un techo de 870 TOPS en INT8 y 288 TFLOPS en FP16.
Para un founder que sirve modelos en producción, el dato que importa no es el pico de cómputo. Es cuánta memoria entra en la tarjeta y cuánta electricidad cuesta mantenerla encendida. Ahí es donde esta ficha se vuelve interesante.
Qué trae exactamente la Cloud AI 100 Ultra
Según las especificaciones publicadas por Qualcomm, la tarjeta llega en formato PCIe FH3/4L (111,2 mm x 237,9 mm), con 150W de TDP, interfaz PCIe Gen4 de 16 lanes, 576 MB de SRAM on-die y 64 núcleos de IA por tarjeta, sobre un nodo de 7 nm. Soporta FP16, INT16, INT8 y FP32.
Leíste lo que hace la IA. ¿Y en tu negocio?
Un agente de IA puede quedarse con parte de tu día: ordenar lo pendiente y pedirte el OK antes de actuar. El Kit «tu mano derecha con IA» trae un video de 11 minutos y una ficha para dejar al tuyo trabajando. CAR está cerrada por ahora; al anotarte, te avisamos cuando abra.
👥 Quiero el Kit →La familia completa, según la misma tabla de producto:
- AI 100 Ultra: 150W, hasta 870 TOPS INT8, 128 GB LPDDR4x, 548 GB/s.
- AI 80 Ultra: 150W, hasta 618 TOPS INT8, 128 GB, 548 GB/s.
- AI 100 Pro: 75W, hasta 400 TOPS, 32 GB, 137 GB/s.
- AI 100 Standard: 75W, hasta 350 TOPS, 16 GB, 137 GB/s.
El salto entre la Pro y la Ultra es de 32 GB a 128 GB de memoria: cuatro veces más capacidad al doble de potencia. Para modelos que necesitan quedar residentes en la tarjeta, esa diferencia decide si el sistema sirve o no.
Qualcomm acompaña el hardware con el AI Inference Suite, un paquete de software con APIs compatibles con OpenAI, soporte para chat, generación de imágenes, capacidades multimodales y RAG, desplegable en Kubernetes o en contenedores bare-metal.
Por qué Qualcomm usa LPDDR en lugar de HBM
La decisión de memoria es la parte estratégica. Qualcomm no compite con la HBM que usan las GPU de entrenamiento: compite con capacidad.
Según TechTimes, la AI200 de Qualcomm soporta hasta 768 GB de LPDDR por tarjeta, frente a los aproximadamente 180 GB de HBM3e de la B200 de Nvidia. La HBM entrega mucho más ancho de banda pico, y por eso domina el entrenamiento, donde ocurren operaciones matriciales masivas en paralelo. La inferencia, sobre todo la fase de decodificación en la que el modelo genera un token a la vez, no está limitada de la misma forma: el cuello de botella es si el modelo completo cabe en memoria y evita transferencias costosas.
La apuesta de Qualcomm es que esa fase premia capacidad sobre ancho de banda pico, y que LPDDR cuesta bastante menos por gigabyte que HBM. La AI250, la siguiente generación que TechTimes ubica en el calendario de 2027, lleva la idea más lejos con una arquitectura de cómputo junto a la memoria, que según las especificaciones de Qualcomm entrega más de 10 veces el ancho de banda efectivo de memoria frente a configuraciones DRAM convencionales, con menor consumo.
El giro de Qualcomm hacia el data center
La Cloud AI 100 Ultra no se entiende sin el movimiento más grande de la compañía.
El 8 de septiembre de 2026, Amazon y Qualcomm anunciaron un acuerdo multigeneracional de silicio personalizado para inferencia y conectividad óptica de hasta 1,6 terabits por segundo, según TechTarget. En el mismo hecho, Qualcomm emitió a una filial de Amazon un warrant por hasta 25 millones de acciones a US$161,26, atado a compras reales de chips y servicios que pueden sumar hasta US$60.000 millones hasta septiembre de 2036, según el formulario 8-K citado por TechTimes. El CFO Akash Palkhiwala confirmó que los ingresos del acuerdo arrancan en el trimestre fiscal de diciembre de 2026, con chips ya en producción.
El portafolio de data center de Qualcomm incluye hoy la CPU Dragonfly C1000, los aceleradores de inferencia AI200, AI250 y AI300, y conectividad de 800G y 1,6T, según TechTarget. La compañía apunta a más de US$15.000 millones en ingresos de data center para el año fiscal 2029, y cerró la compra de Modular en julio de 2026 para reforzar su capa de software.
Cómo se está moviendo el mercado de inferencia
El contexto favorece a los especialistas. TrendForce proyecta que los envíos de chips de IA personalizados crezcan 44,6% en 2026, contra 16,1% de las GPU de propósito general, según TechTimes. Ese mismo informe cita estimaciones de SemiAnalysis y Bernstein según las cuales los ASIC ofrecen una ventaja de costo total de propiedad de 40% a 65% frente al silicio de mercado en despliegues de inferencia a gran escala y de varios años.
El caso más citado es Midjourney, que según TechTimes bajó su costo mensual de cómputo de aproximadamente US$2,1 millones a US$700.000 al mover cargas de inferencia de GPU de Nvidia a las TPU de Google. Nvidia sigue concentrando entre 70% y 80% del mercado de aceleradores de IA por ingresos, pero la presión se siente en la capa de inferencia.
No es solo Qualcomm. Microsoft presentó la Maia 300 el 12 de octubre de 2026, con 288 GB de HBM4 y 18 TB/s de ancho de banda por acelerador en una envolvente de 950W, según TechRepublic. La comparación con los 150W de la Cloud AI 100 Ultra muestra dos filosofías opuestas: máxima densidad de cómputo contra eficiencia por vatio.
Qué significa esto para tu startup
La buena noticia es que casi ninguna startup hispanohablante va a comprar estas tarjetas. La mala es que las decisiones de infraestructura que tomes hoy van a condicionar tu costo por token de los próximos dos años.
- Mide costo por token, no FLOPS. Evercore describió el entorno actual como un régimen liderado por la inferencia, donde los criterios de compra se movieron del throughput máximo al costo por token, la potencia, el enfriamiento y la utilización, según TechTimes. Si tu panel de control no tiene esa métrica, empieza por ahí.
- Separa tus cargas por tipo. El procesamiento inicial de la consulta del usuario y la generación secuencial de tokens tienen requisitos distintos. Si tu producto es un chatbot o un agente que genera texto token a token, tu cuello de botella es memoria, no ancho de banda pico.
- No te cases con un solo proveedor de cómputo. La ventaja del ecosistema CUDA es real, pero la portabilidad es tu seguro. Evalúa stacks que te permitan mover un modelo entre Nvidia, AMD y silicio alternativo sin reescribir todo.
- Mira los benchmarks de eficiencia, no los de pico. La colaboración entre Multiverse Computing y Qualcomm, presentada en el MWC de marzo de 2026, corrió un modelo comprimido sobre una Cloud AI100 Ultra y reportó hasta 93% menos tiempo de respuesta, 44% más throughput, 45% menos uso de memoria y 21% menos consumo, sin pérdida de precisión, según el comunicado difundido por Yahoo Finance. Ese tipo de ganancia, la compresión de modelos, la puedes capturar hoy sin cambiar de hardware.
Conclusión
La Cloud AI 100 Ultra no es una tarjeta que vayas a comprar. Es una señal de hacia dónde se mueve la infraestructura de IA: menos pico, más eficiencia; menos flexibilidad genérica, más especialización por carga.
Para un founder, la lectura práctica es simple. El costo de servir un modelo dejó de ser un problema de ingeniería y pasó a ser un problema de márgenes. Quien entienda antes qué métrica manda en su caso, si memoria, potencia o costo por token, va a tener una ventaja concreta cuando negocie con su proveedor de nube.
Fuentes
- Qualcomm Cloud AI 100 Ultra (fuente original)
- Qualcomm Wins First Western Hyperscaler: AWS Deal Pays Up to $60B for Inference Silicon
- Amazon’s $60B Qualcomm deal expands AI inference hardware
- Multiverse Computing and Qualcomm Collaborate to Bring Efficient AI Models to Data Centers
- Custom AI Chips Outpace Nvidia GPU Growth in 2026
- Microsoft Maia 300 vs Nvidia Rubin: Specs, Not Benchmarks
Leíste lo que hace la IA. ¿Y en tu negocio?
Un agente de IA puede quedarse con parte de tu día: ordenar lo pendiente y pedirte el OK antes de actuar. El Kit «tu mano derecha con IA» trae un video de 11 minutos y una ficha para dejar al tuyo trabajando. CAR está cerrada por ahora; al anotarte, te avisamos cuando abra.
👥 Quiero el Kit →